60分靠数据,100分靠自进化:清华曹婷和「域变换」攻向机器人可部署
60分靠数据,100分靠自进化:清华曹婷和「域变换」攻向机器人可部署具身智能讨论的核心问题正在改变:从谁有更多数据能做出更强基础模型,转向谁能把机器人真正部署到现场,并让它持续做成任务。
来自主题:
AI资讯
8993 点击 2026-09-10 10:21

 搜索
具身智能讨论的核心问题正在改变:从谁有更多数据能做出更强基础模型,转向谁能把机器人真正部署到现场,并让它持续做成任务。
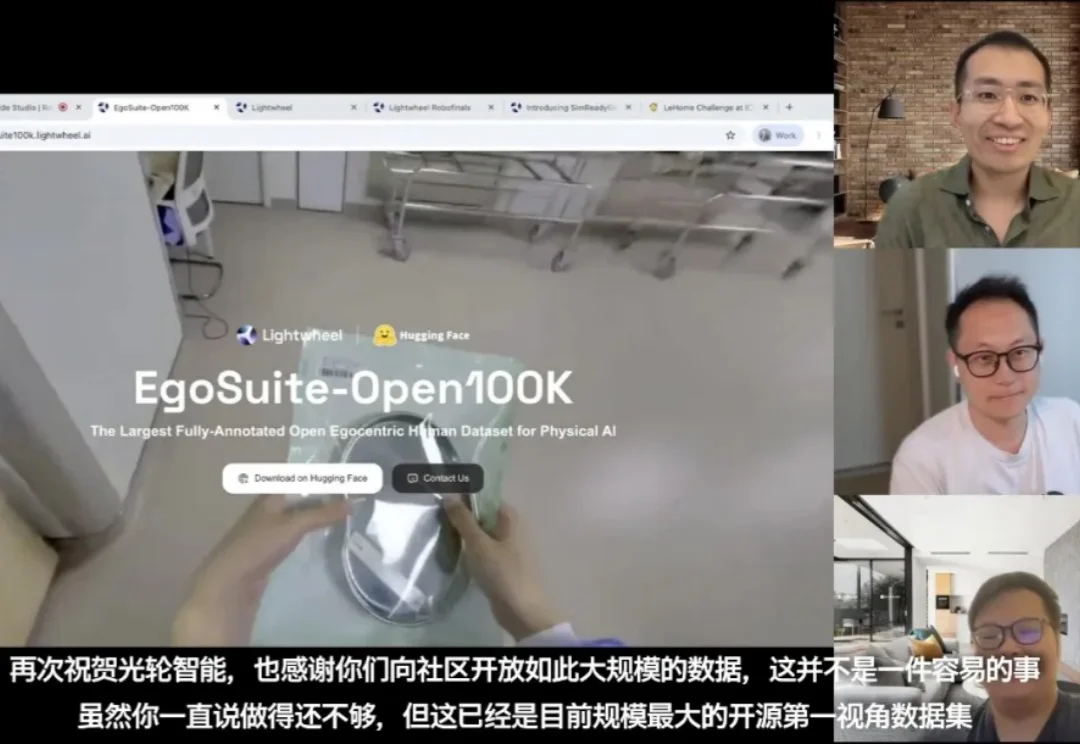
近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
AI圈现在卷得最凶的地方,是你的电脑桌面。
五大助听器品牌垄断 30 年,AI 能突破吗?
「我今天从Anthropic辞职了!」
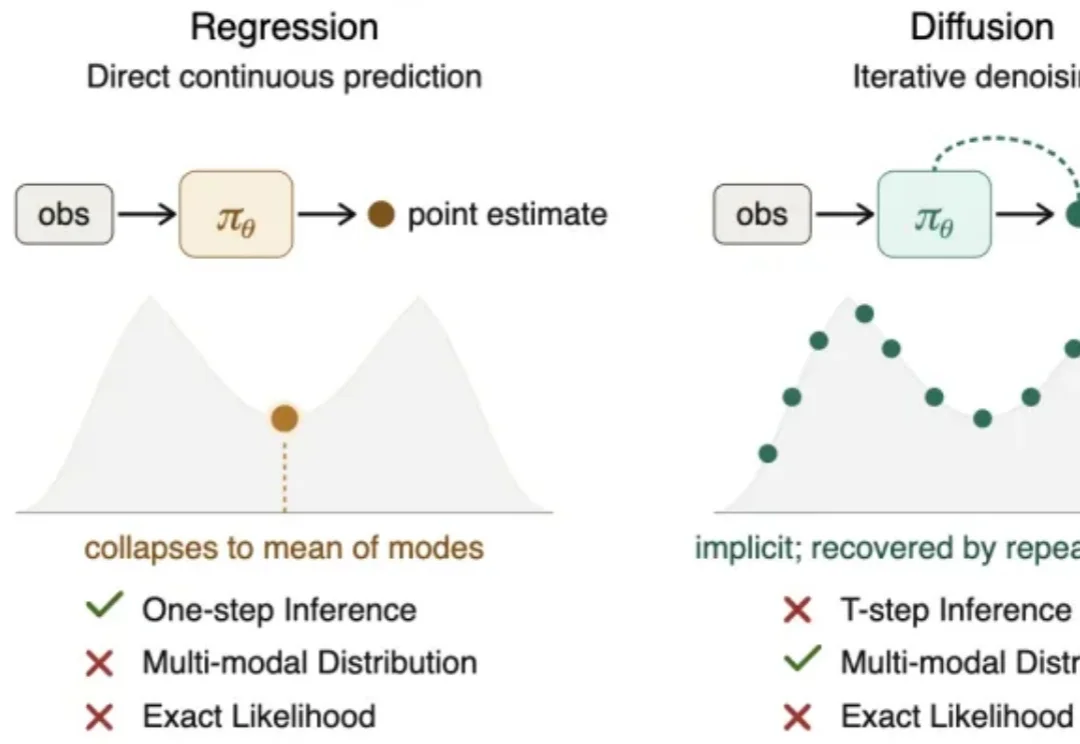
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
最新消息,参数293B的讯飞星火X2.5上线了……
四年前,法国举办的一场 CNCF 大会上,主持人向台下的大模型创业者抛出一个常规问题:“Kubernetes 能为 AI 带来什么?”
9月6日晚间,我在北京朝阳一个文创园里见到了导演李东珅。从早到晚,他一天都在采访中,而我们也不是他当天见的最后一波媒体。他给我们泡茶,招呼吃披萨——看得出疲惫,但更显眼的是兴奋——这位过去“曲高和寡”的纪录片导演,第一次被如此密集的流量包围。
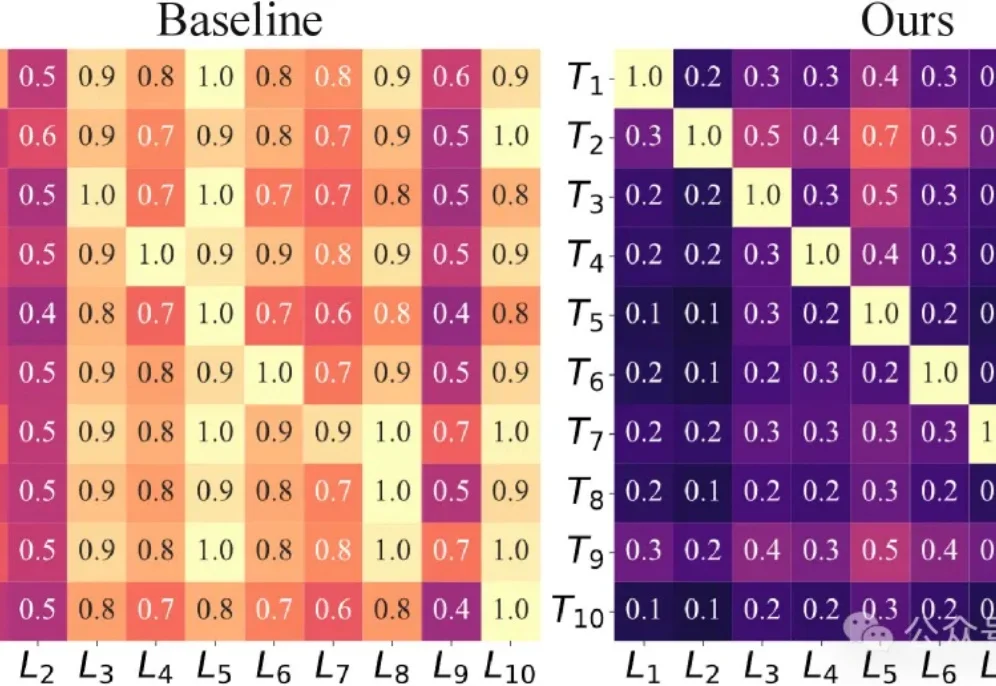
AIGC相关创作中,多个LoRA合并到一起,画风串味、角色崩坏几乎是必然。
初中时候,看《科幻世界》看得很痴迷。
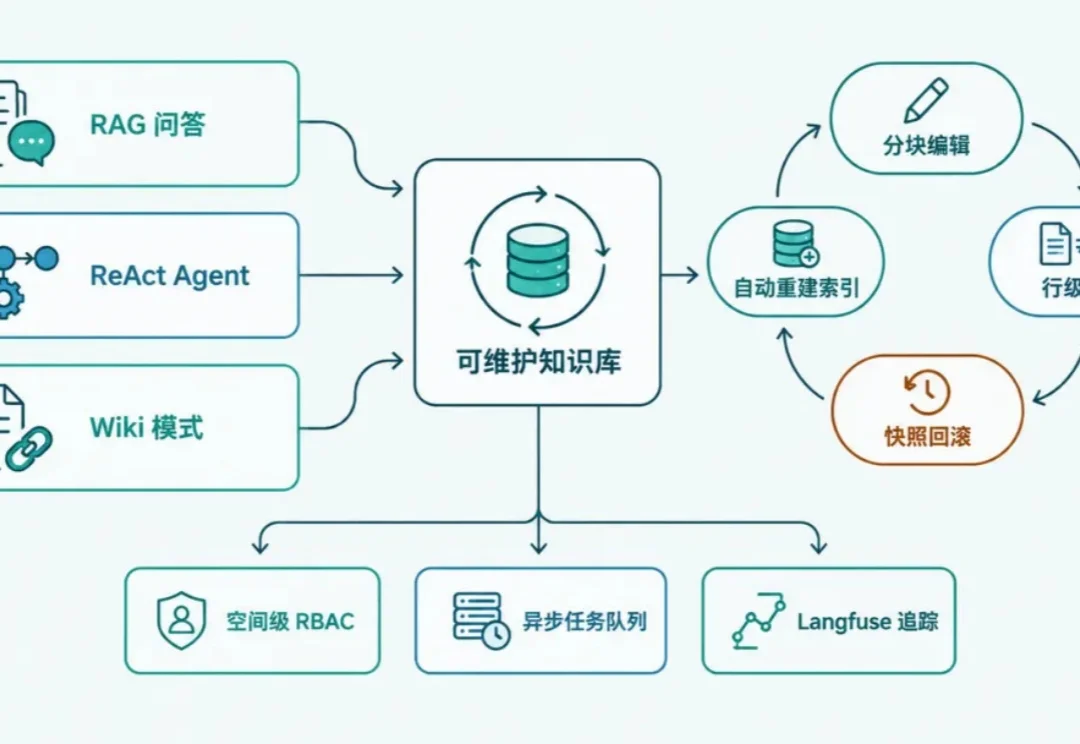
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。
阿里旗下阿里云正在内测AI投研工具"Qovest",定位为面向专业个人投资者的AI金融投研助手,首批验证A股条件检索、Deep Research、持续跟踪等功能,瞄准独立研究习惯的个人投资者,补齐国内投研工具市场结构性缺口,卡位AI金融赛道。
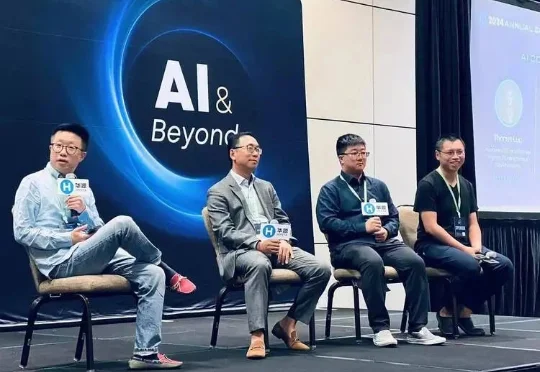
李沐在小红书开设AMA在线答疑,围绕AI时代的学习方向、编程必要性、职业选择与具身智能等话题回答网友提问,建议普通人善用Agent、保持深度优先并重新思考人与AI的分工。
作者实测使用招商银行 Mastercard 借记卡,通过 Google Play 成功订阅 ChatGPT Plus,并在扣款后核验订阅记录与 Plus 权益。
主动型AI开始冒头。
AI设计走向专业化。
杭州人工智能企业DeepSeek已选定中信证券全面筹备科创板上市事宜,有望本年度内正式递交IPO申报材料,公司当前最新估值约5000亿元人民币。
太震撼了! 就在刚刚,谷歌DeepMind正式发布「阿尔法」重磅成果——AlphaGenome Atlas。这是一个有前沿AI加持、覆盖全基因组的可搜索预测数据库。
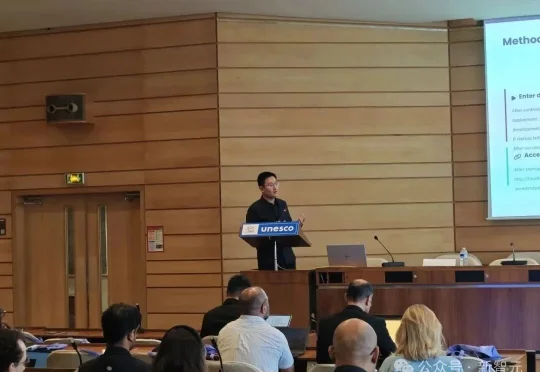
打造出圈级AI「龙虾老师」的清华团队,这一次,在联合国的讲坛上开坛授课了!现场,来自清华大学教育学院的张羽教授、助理教授于济凡,完成一场90分钟的AI教育实战——用一个开源项目,从零做出一门课。
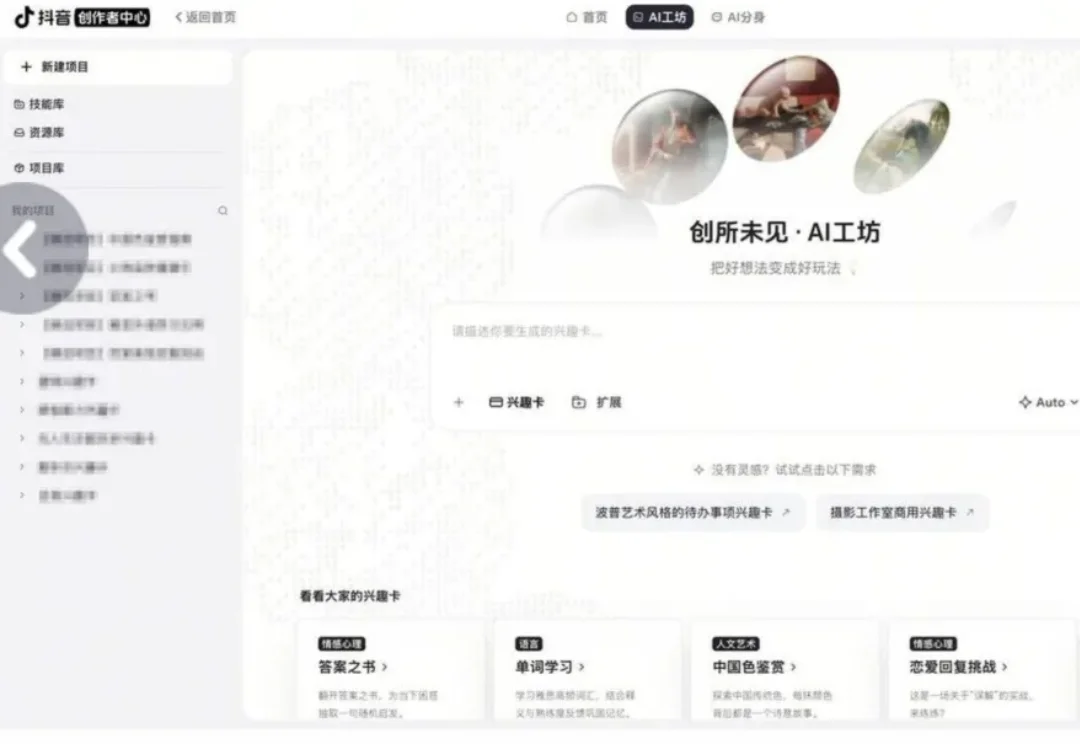
或许不久之后,抖音推荐页的内容就不只是短视频、短剧、图文、直播和小游戏,可能还有“AI应用”。
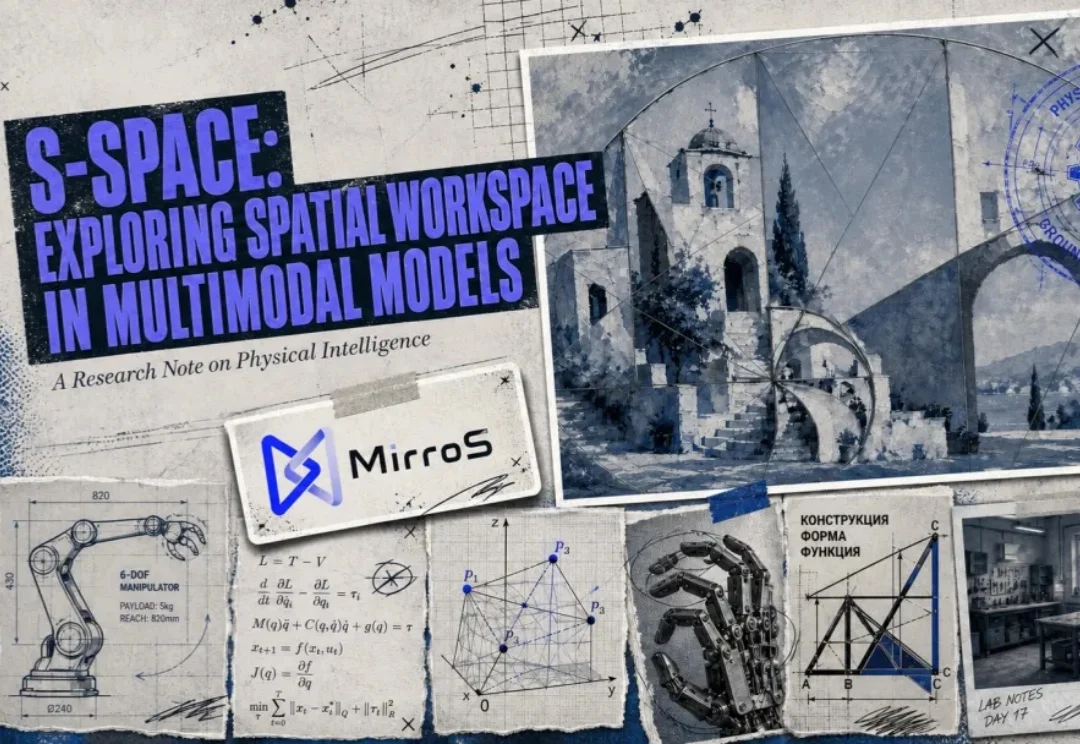
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
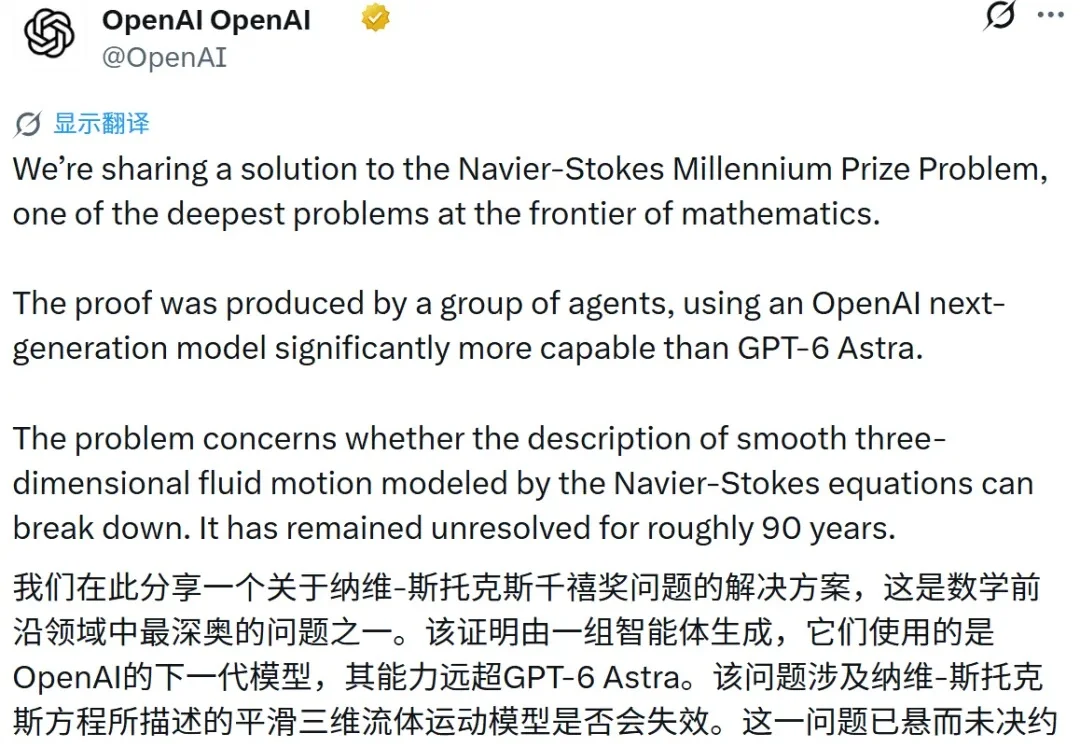
刚刚,OpenAI 发文投下一颗重磅新闻,称他们使用一种比 GPT-6 Astra 更强大的、未公开的下一代前沿大模型,联合约 10000 个并发协作的 AI Agent,仅耗时 88 个小时,便攻克了克雷数学研究所设立的七大千禧年难题之一 —— 纳维 - 斯托克斯方程(Navier-Stokes Equation)的存在性与光滑性问题。
一家正在营业的超市里,一台轮式机器人正沿着货架缓慢移动。
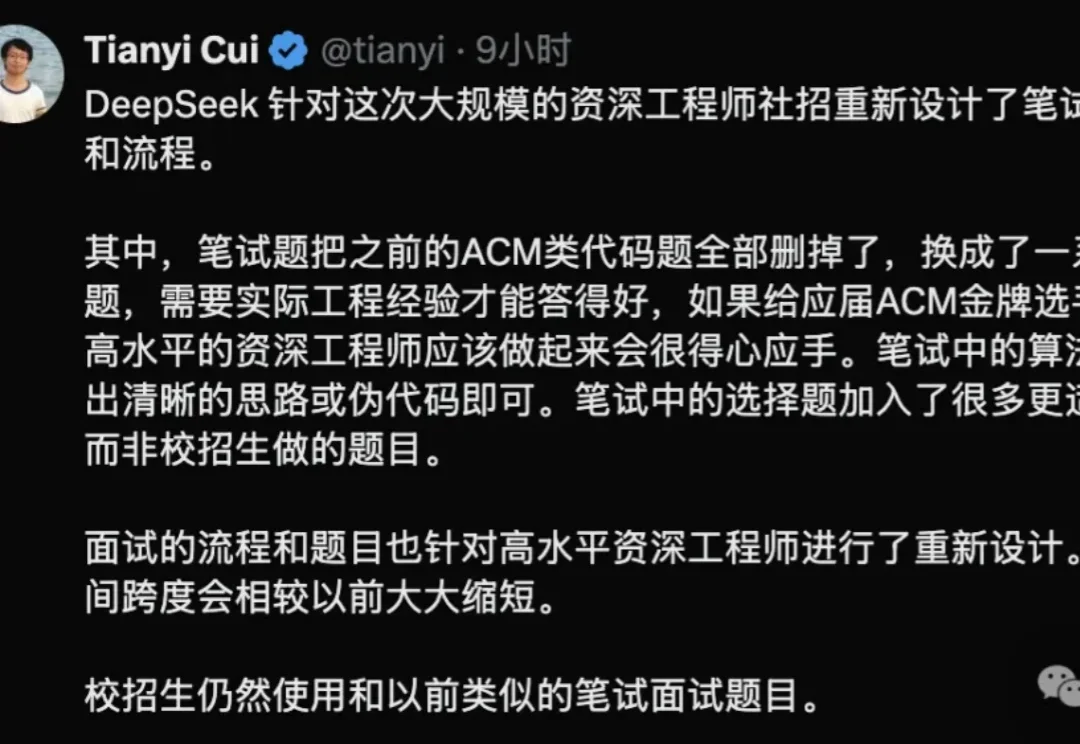
DeepSeek为了150人大规模社招,把整个面试流程重新设计了。
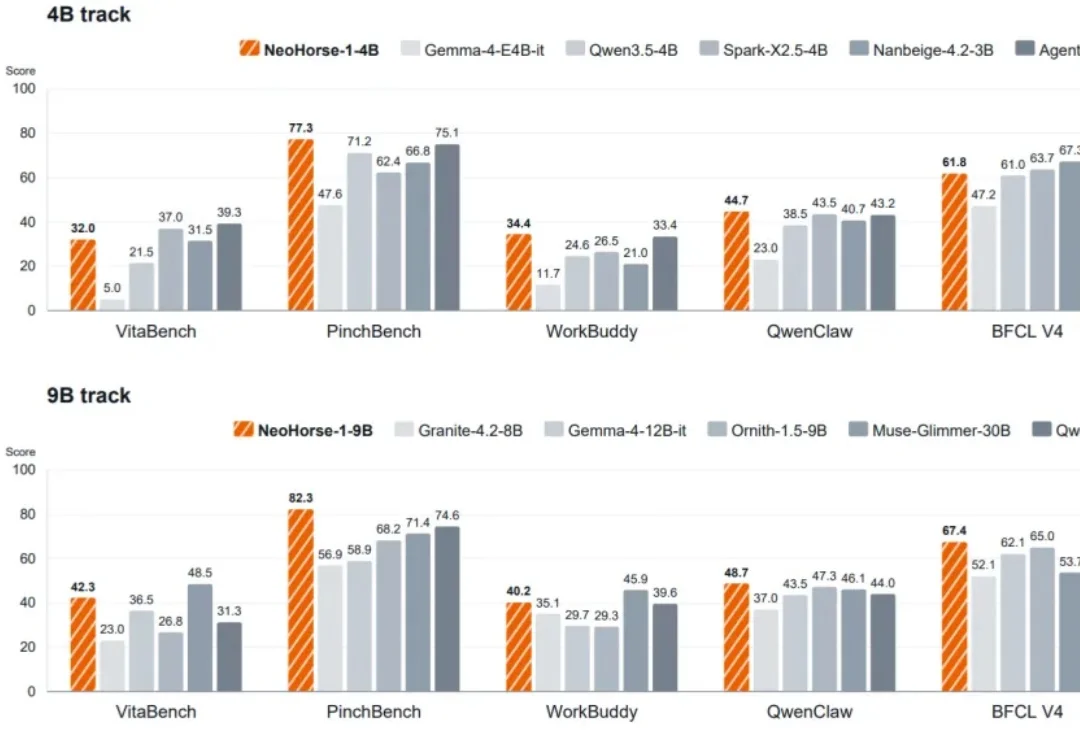
Agent 完成任务后,学到的经验去了哪里?
办公 Agent 下半年开启了大乱战模式。
模型正在接手更多复杂工具。
上周,《后西游记》在湖南卫视黄金档时段上映。
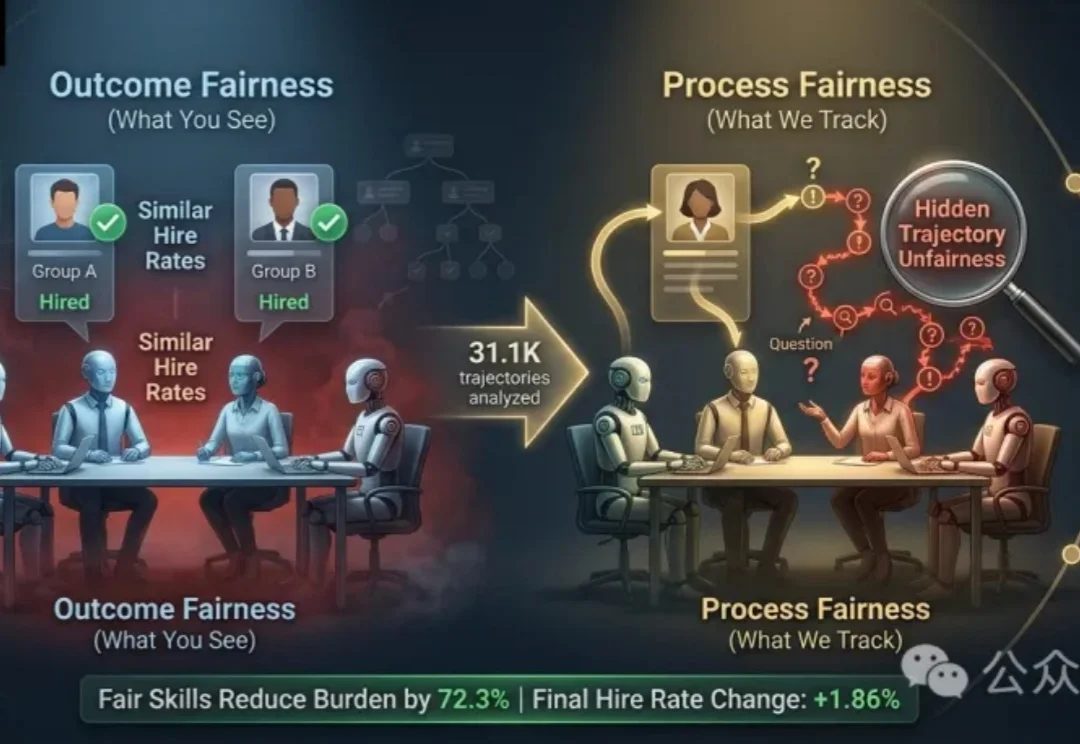
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。