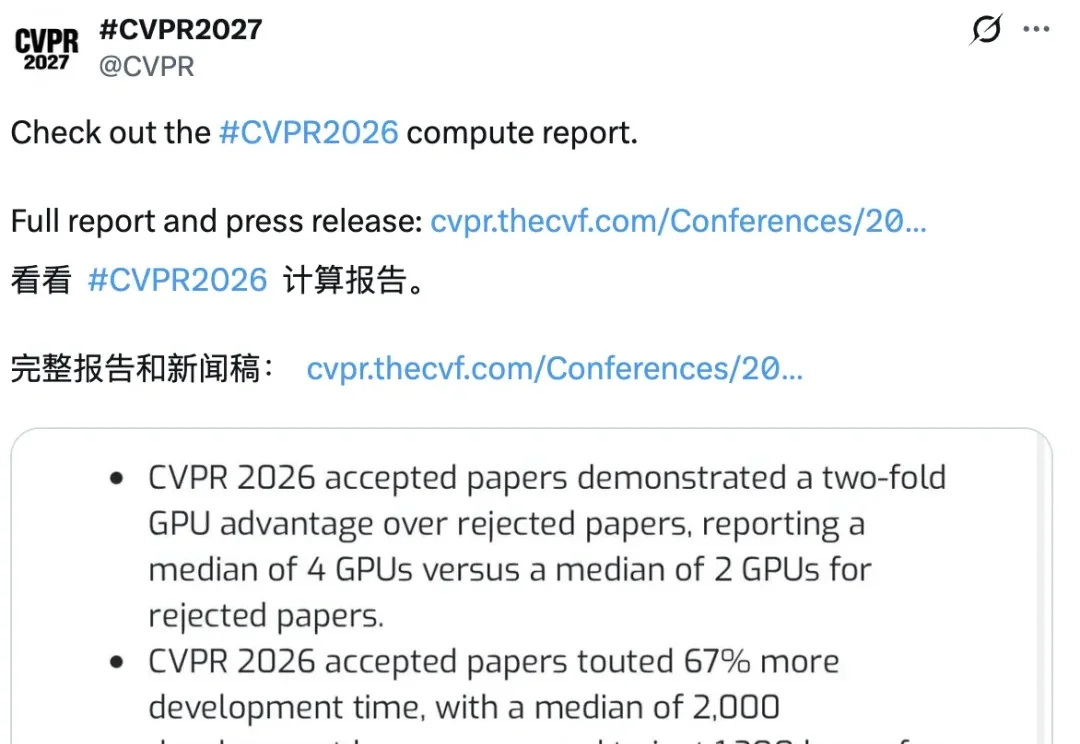
卡多确实更容易发顶会!CVPR发布算力报告
卡多确实更容易发顶会!CVPR发布算力报告AI顶会论文,到底有多拼卡?
来自主题:
AI资讯
7890 点击 2026-11-03 11:01

 搜索
AI顶会论文,到底有多拼卡?
大模型吃光互联网后,机器人的物理Token从哪来?
用螺丝刀拧紧螺丝,听起来并不复杂。
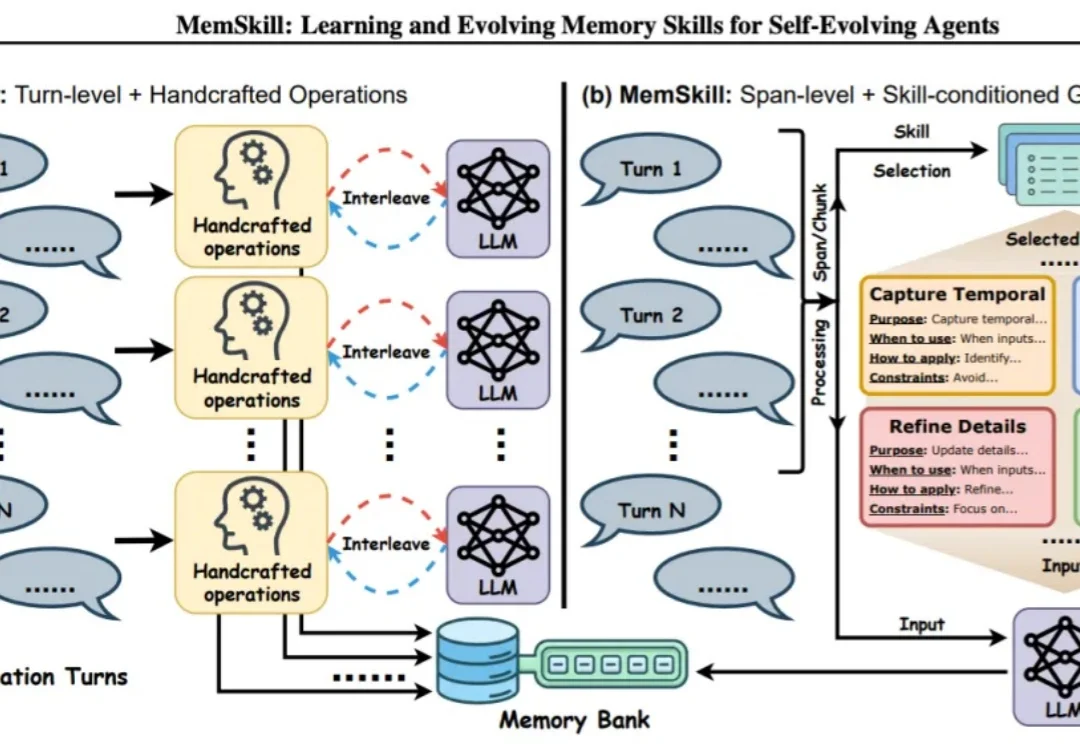
随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
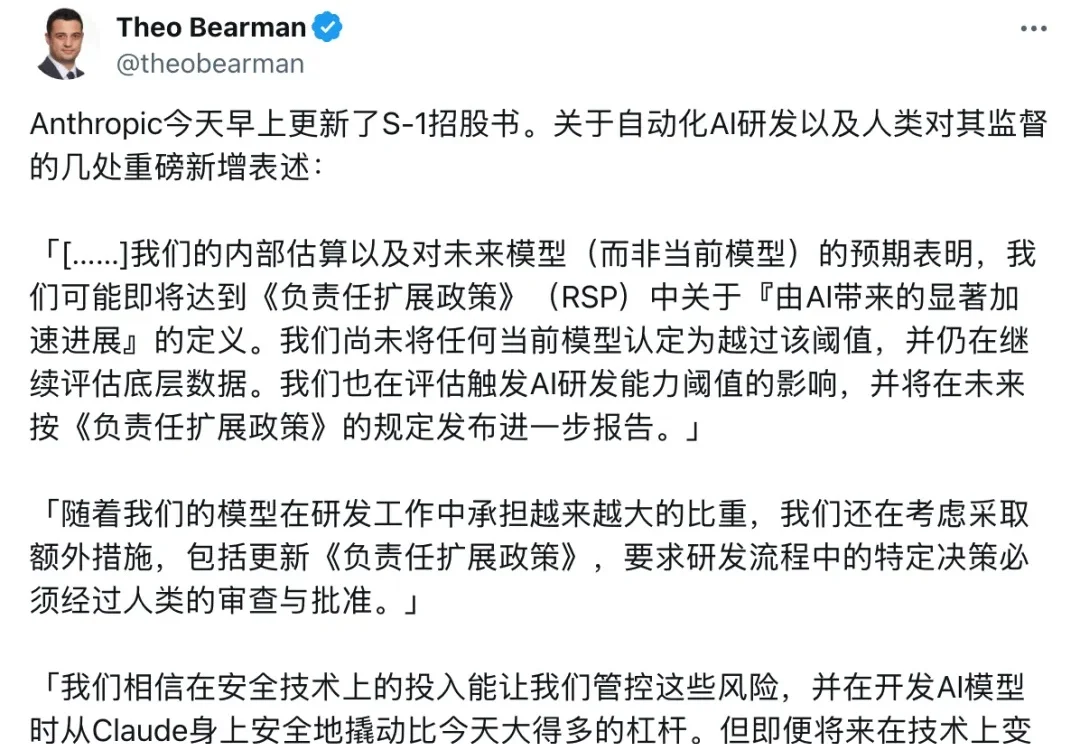
造AI的人,已来不及看清AI进化到了哪一步!
过去几年,神经网络接连改写了一个又一个领域:图像生成有了 Stable Diffusion,视频生成已经能做到以假乱真,就连 3D 渲染也出现了 RenderFormer 这样的纯神经网络方法。但在高保真物理仿真上,神经网络始终没能交出令人满意的答卷,游戏、动画和机器人领域至今仍依赖需要手动调参、难以求梯度的传统求解器。
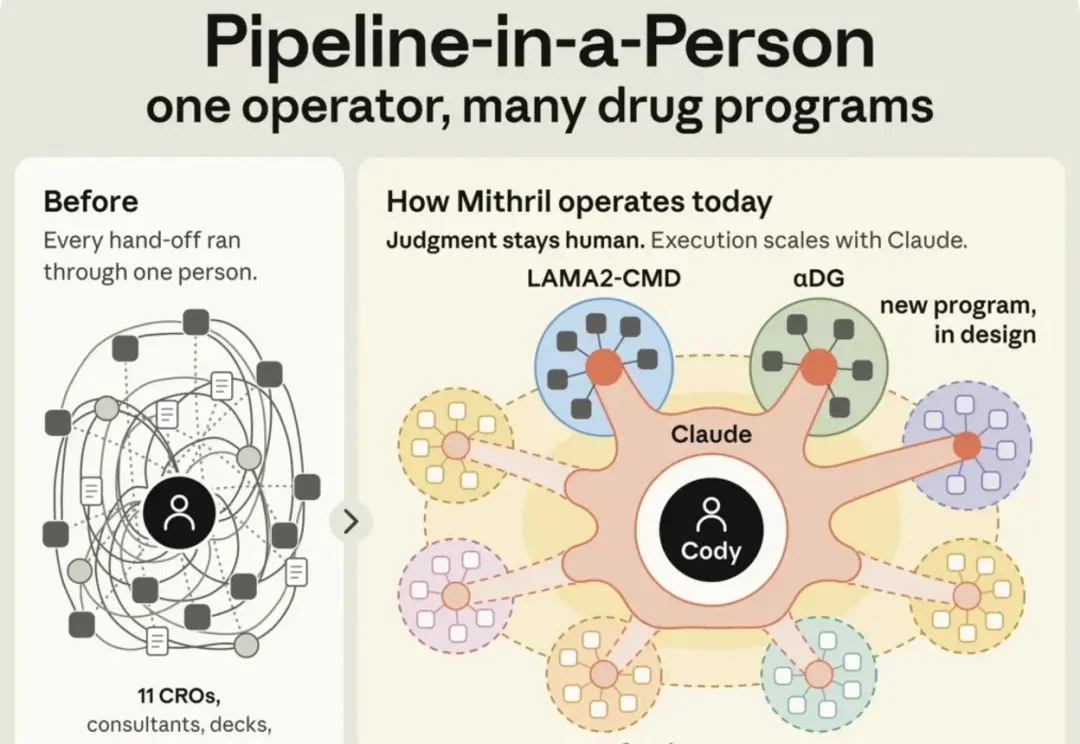
最近, Anthropic 买了一家新公司。
国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。
OpenAI攻克千禧难题的「神兽」,终于要出笼了!
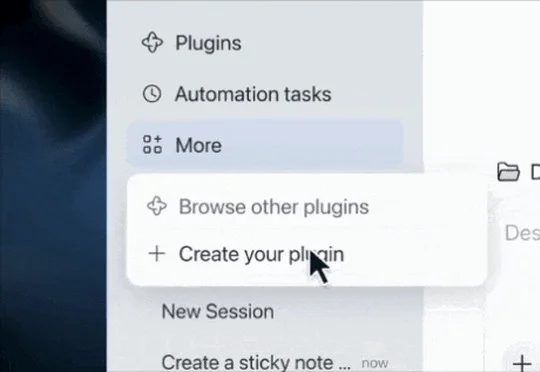
DeepSeek Harness官方发布“创造模式”(Creator Mode)指南,用户输入一句自然语言即可让AI编写并安装插件,同时免费公开7套官方提示词,示例覆盖3D建模与游戏、视频剪辑、海报设计、论文阅读、界面改造和Token统计。
AniShort推出原生本地架构的AI影视工作台,接入Codex等智能体,支持自动质检、自定义模型API、Skill复用及本地专业软件协同。
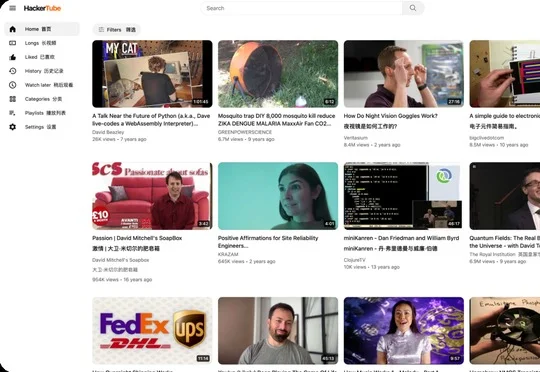
Karpathy 借助 Claude Code 和 Claude Opus 5.5 的 Medium 推理强度,两小时做出基于 YouTube 视频与 Hacker News 推荐数据的 HackerTube,表明 AI 可用于构建更符合个人偏好的互联网信息入口。
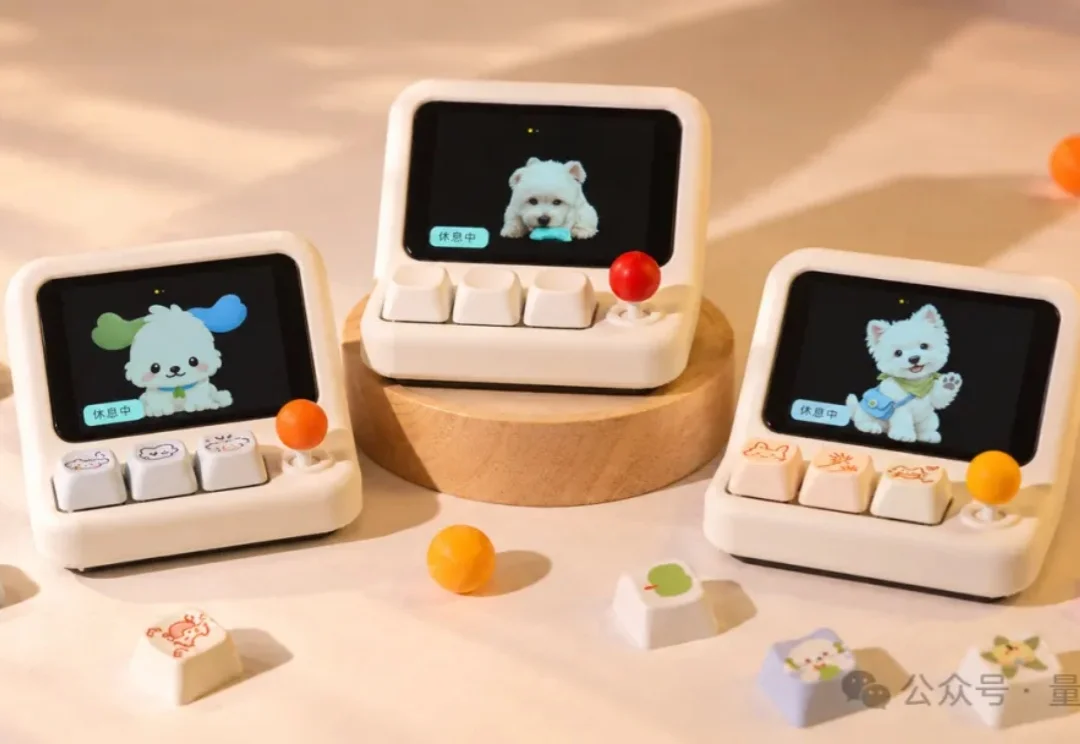
一块小屏幕,三个按键,一个摇杆,屏幕里的西高地小狗时而忙碌,时而发愁,时而庆祝。
AI发展的这两三年里, 我真的算是亲眼看着它在创作和代码这两条赛道上一路狂奔。
AI改造的风,从大厂一路吹到县城,吹进那些急于转型的小公司。
“你要不要上车?”
“个人 Agent创业窗口期就到春节前。”
660倍的参数差距,结果小模型赢了?!
还记得电影《Her》里的 Samantha 吗?
让大模型「多想一会儿」,今天几乎等同于让它多写一些字:先生成一段思维链,再给出答案。
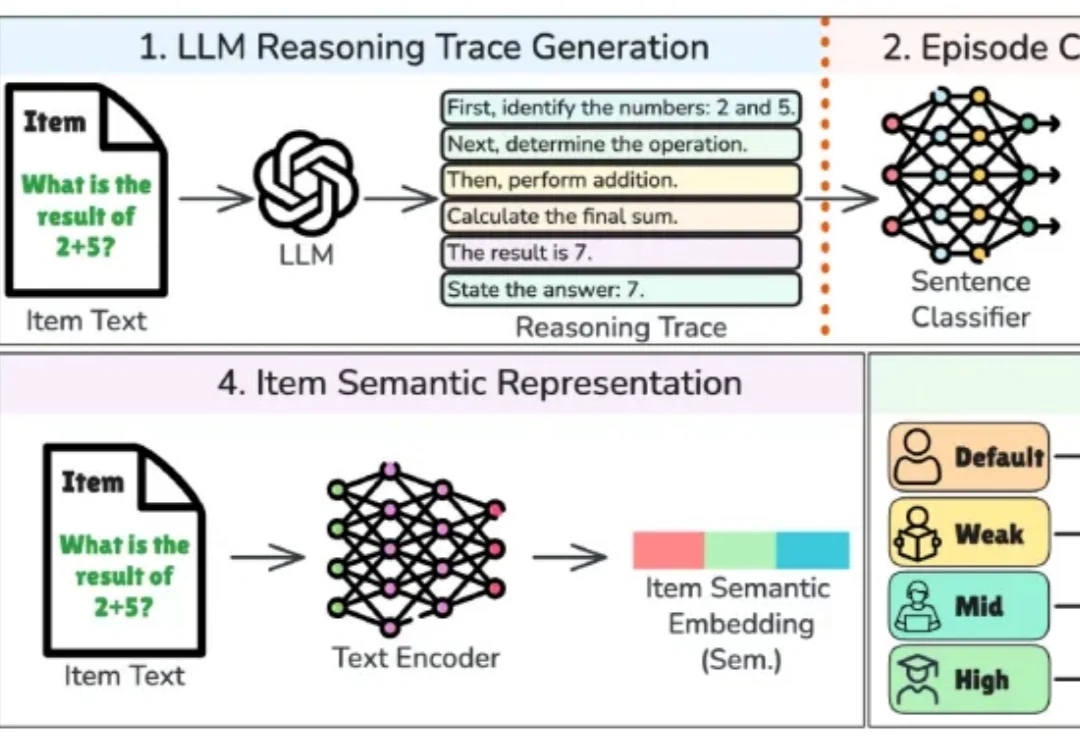
一道试题对人来说有多难,能否从大模型的解题过程中找到线索?
AI江湖的名头换了一茬又一茬:AI四小龙、大模型六小虎……
“在每一个有创造性活动的领域里,一个人的Taste,加上他的能力和机遇,决定了他的风格;而他的风格,反过来决定了他的贡献。因此Taste和风格之于科学研究,就像它们对文学、艺术和音乐一样至关重要。”
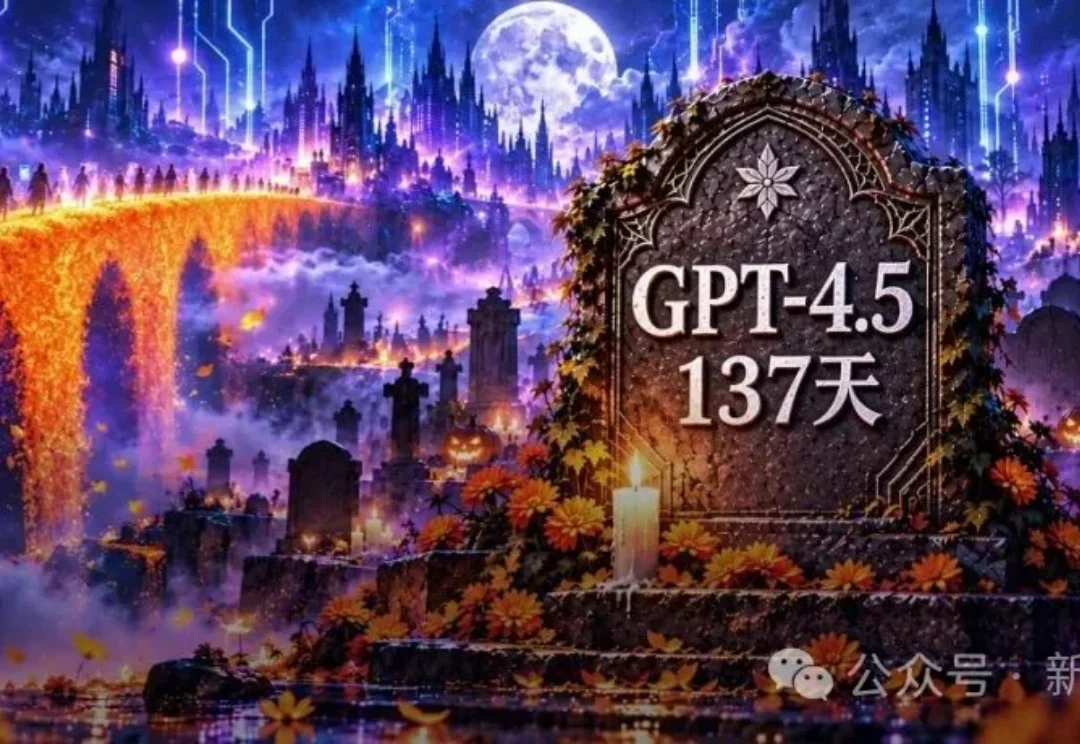
最近,我把两家大厂的模型下线表翻了一遍,答案是越来越短。赶上万圣节,就当给这些下了线的 AI 点根蜡烛。
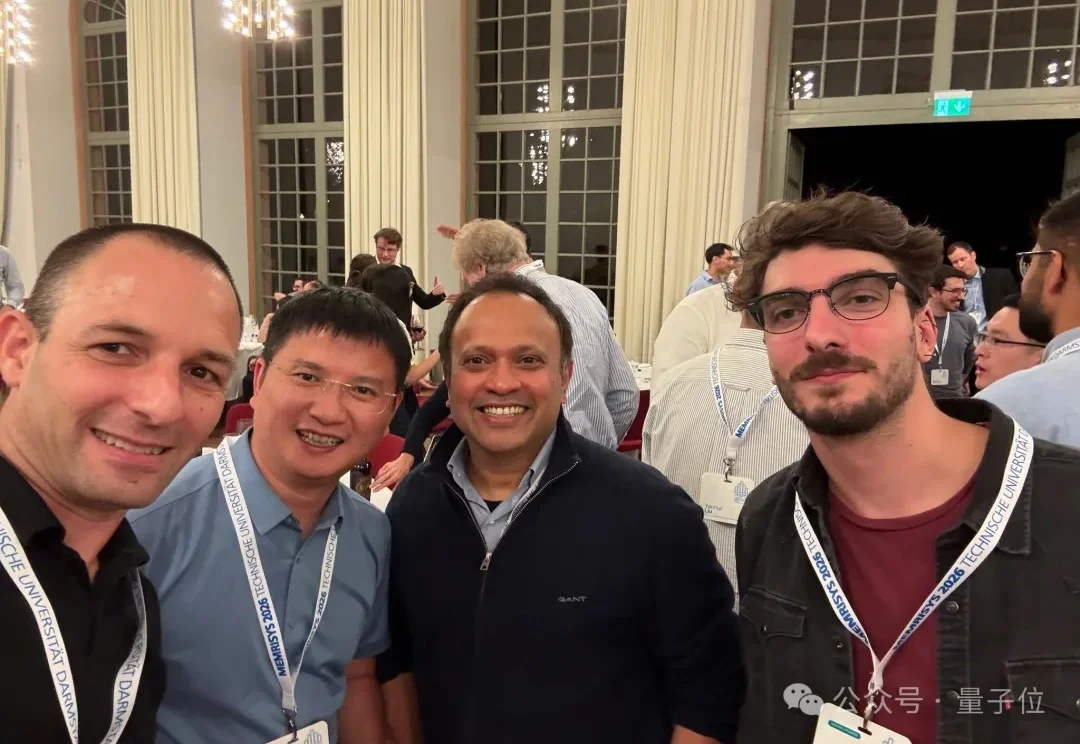
人类用了两千年的模拟计算,开始被重新定义了。
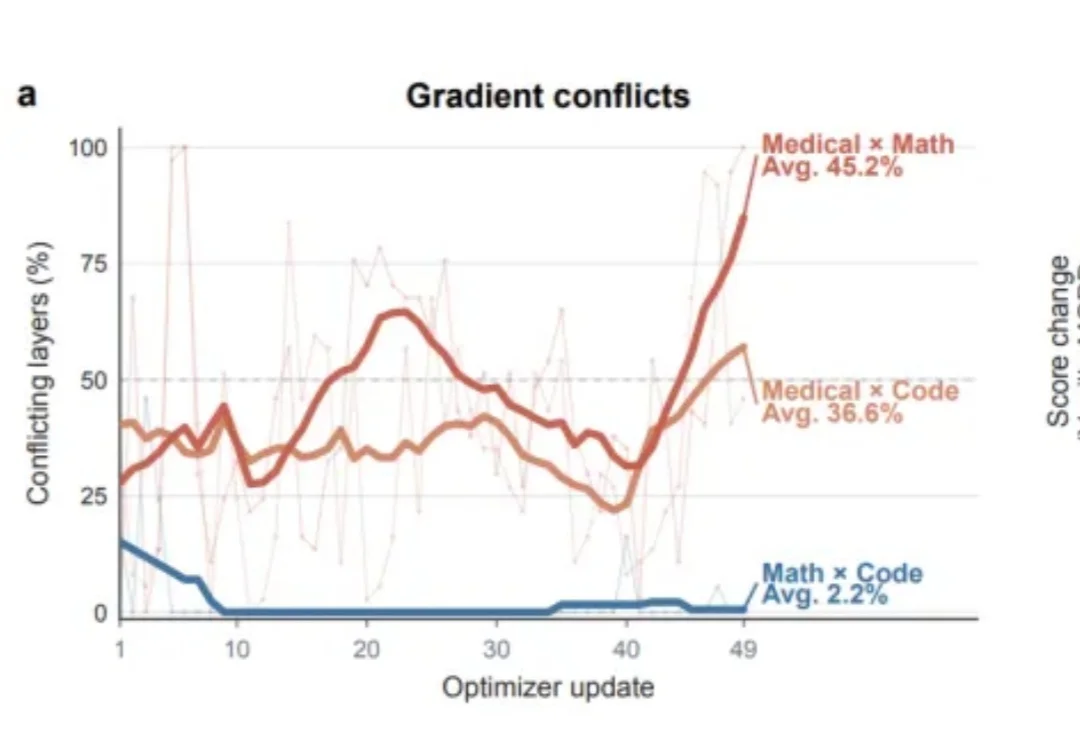
数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
两大新模型爆料,竟撞在了同一天!
昨天做了一份动态图解《DeepSeek 的 Super-agent 架构》,然后便看到 Max(前段时间加入了 LobeHub)发了个朋友圈
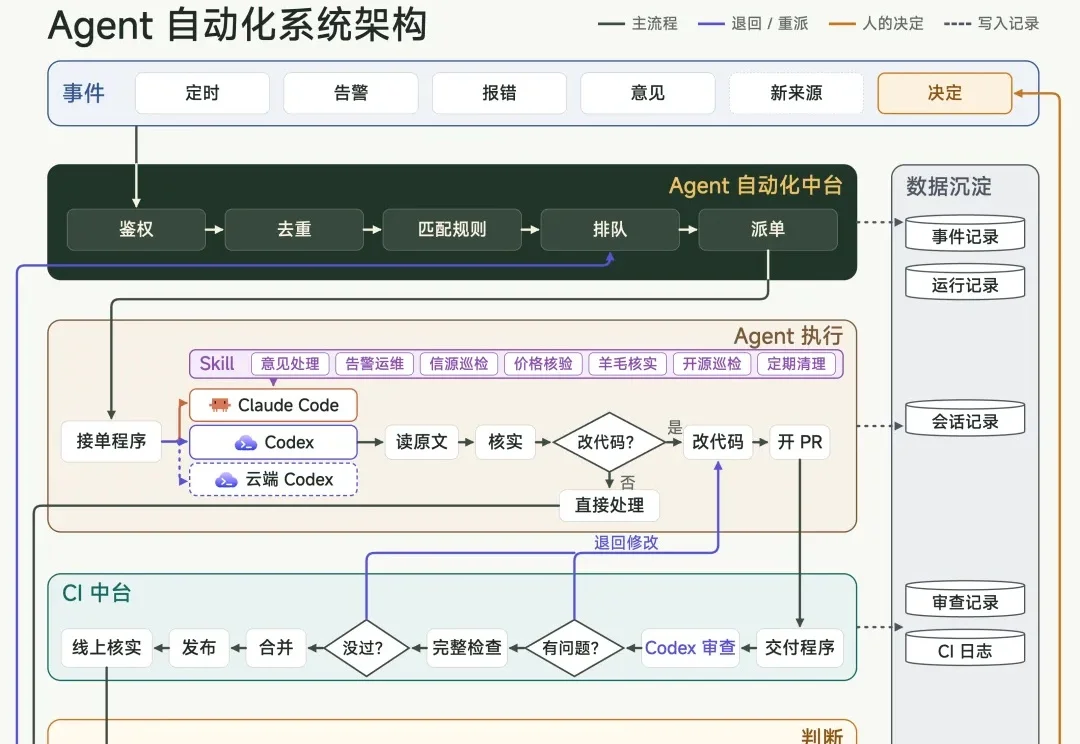
上周六的时候,DeepSeek发了他们一篇很长的技术文章,叫《Super-agent设计探索:迈向更自主的Agent系统》,细细读完了,非常棒的架构,对很多开发者来说,都非常非常值得学习。
近日,达瓦科技披露,公司年内连续完成 Pre-A 轮、A 轮融资,累计融资金额近5亿元,投资机构包括启赋资本、投控东海、一村资本、宝捷会、鞍羽资本及多家产业投资机构,老股东持续加注。鞍羽资本担任公司长期独家财务顾问。