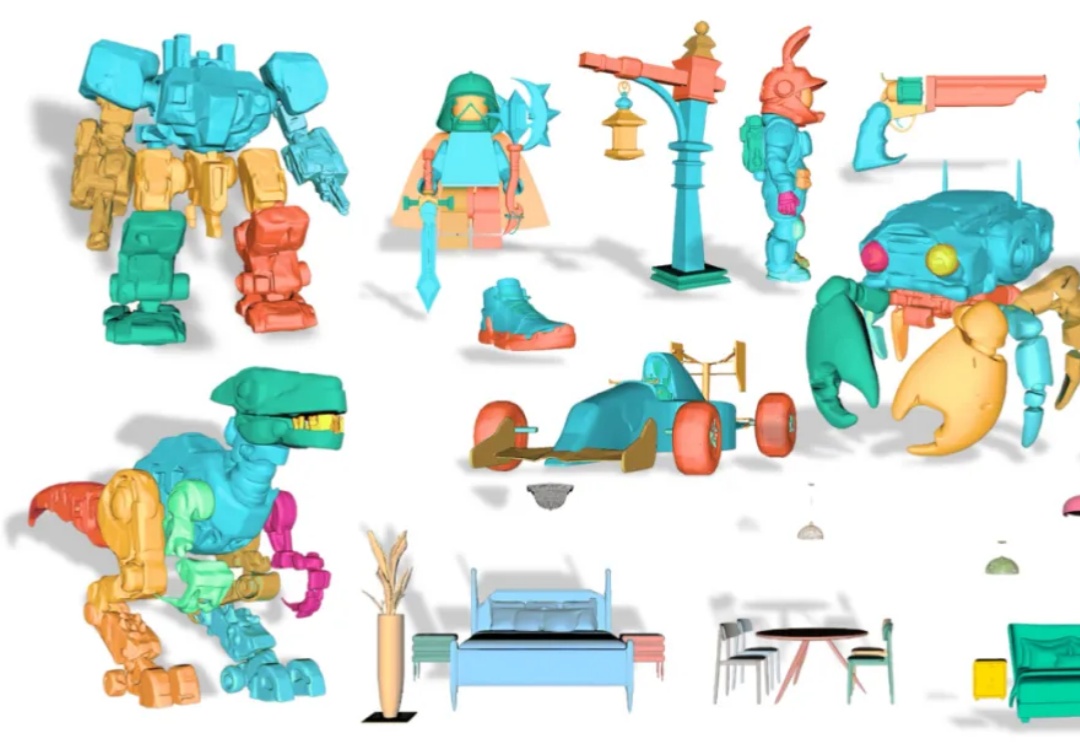
首个3D生成解构模型PartCrafter问世,GitHub狂揽2k星标
首个3D生成解构模型PartCrafter问世,GitHub狂揽2k星标从单张图像创建可编辑的 3D 模型是计算机图形学领域的一大挑战。传统的 3D 生成模型多产出整体式的「黑箱」资产,使得对个别部件进行精细调整几乎成为不可能。
来自主题: AI技术研报
11566 点击 2025-11-27 15:01

 搜索
从单张图像创建可编辑的 3D 模型是计算机图形学领域的一大挑战。传统的 3D 生成模型多产出整体式的「黑箱」资产,使得对个别部件进行精细调整几乎成为不可能。
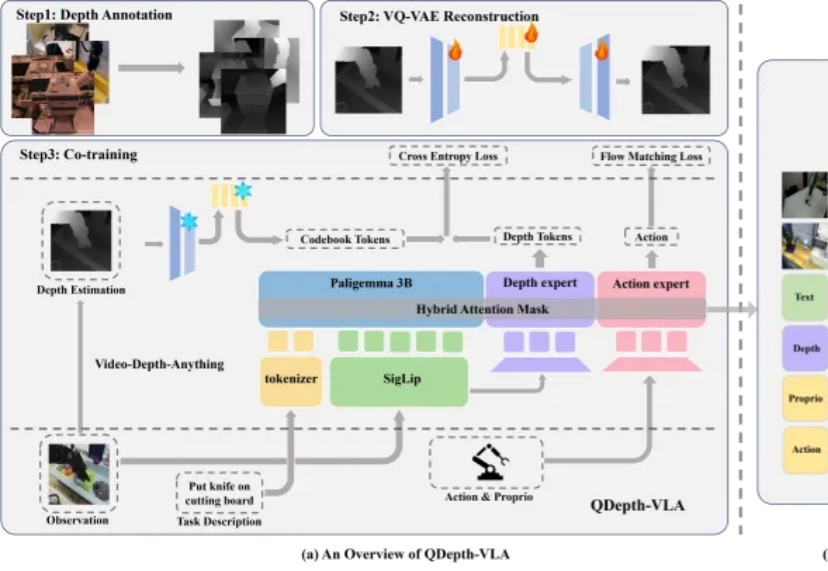
视觉-语言-动作模型(VLA)在机器人操控领域展现出巨大潜力。通过赋予预训练视觉-语言模型(VLM)动作生成能力,机器人能够理解自然语言指令并在多样化场景中展现出强大的泛化能力。然而,这类模型在应对长时序或精细操作任务时,仍然存在性能下降的现象。
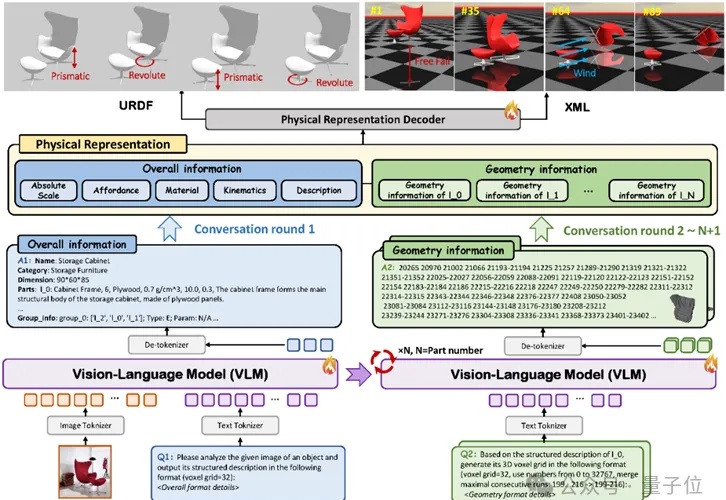
一张照片,就能生成可直接用于仿真的3D资产。

Meta 用一段文本构建可探索的 3D 世界。 这就是 Meta 最新公布的一项突破性研究 WorldGen:只需一段文本提示就能生成真正可导航、可交互、可以走进去探索的完整 3D 世界。

沉默后爆发?
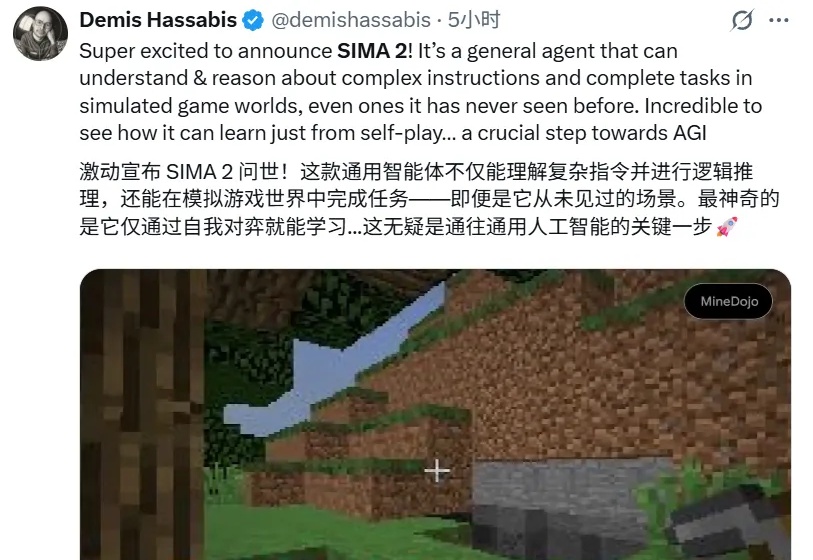
您的 AI 伙伴「游戏陪玩」版已上线。
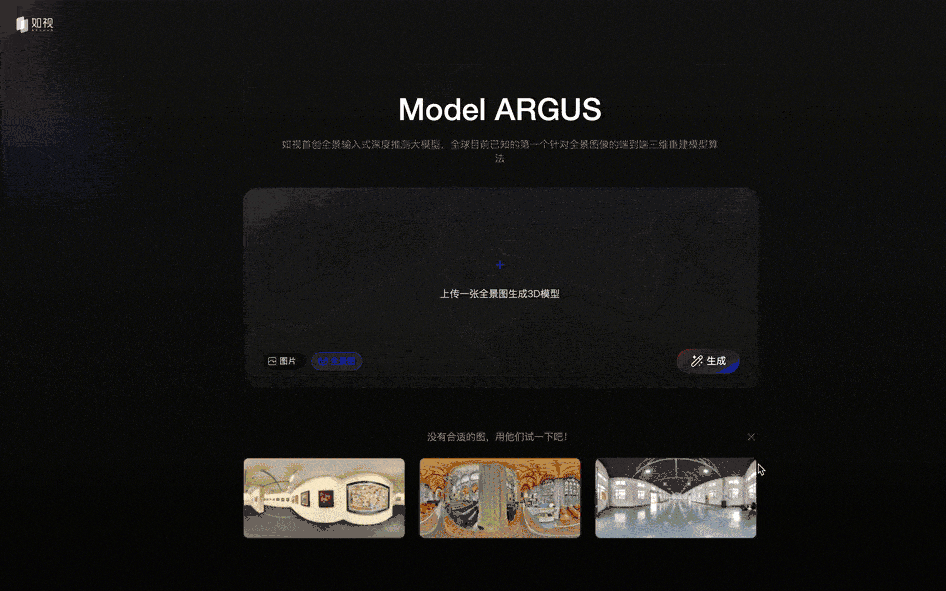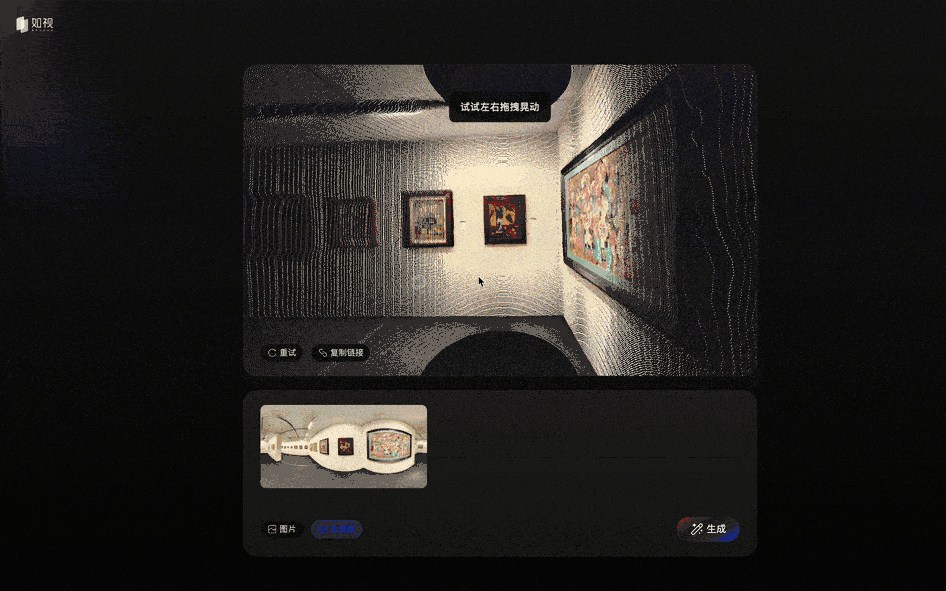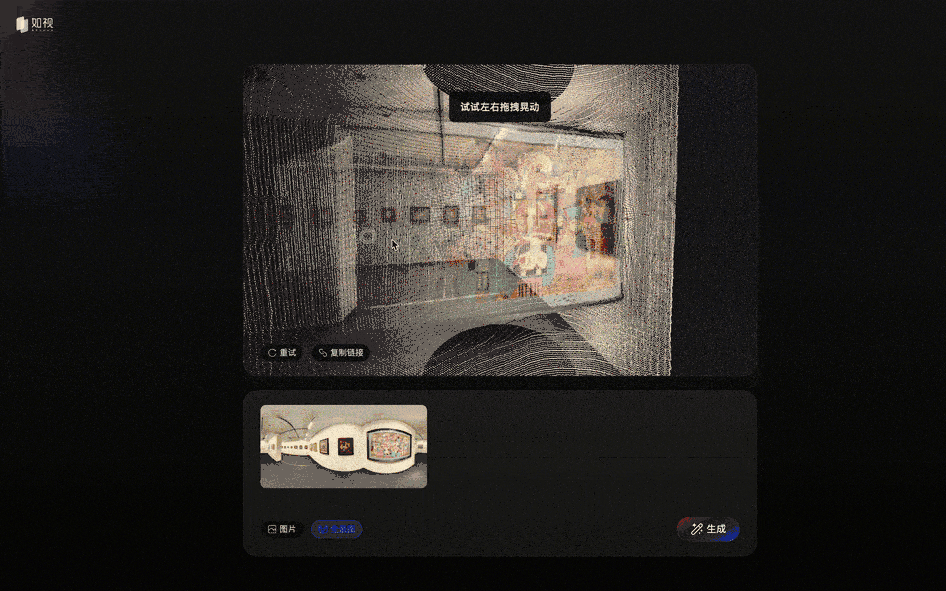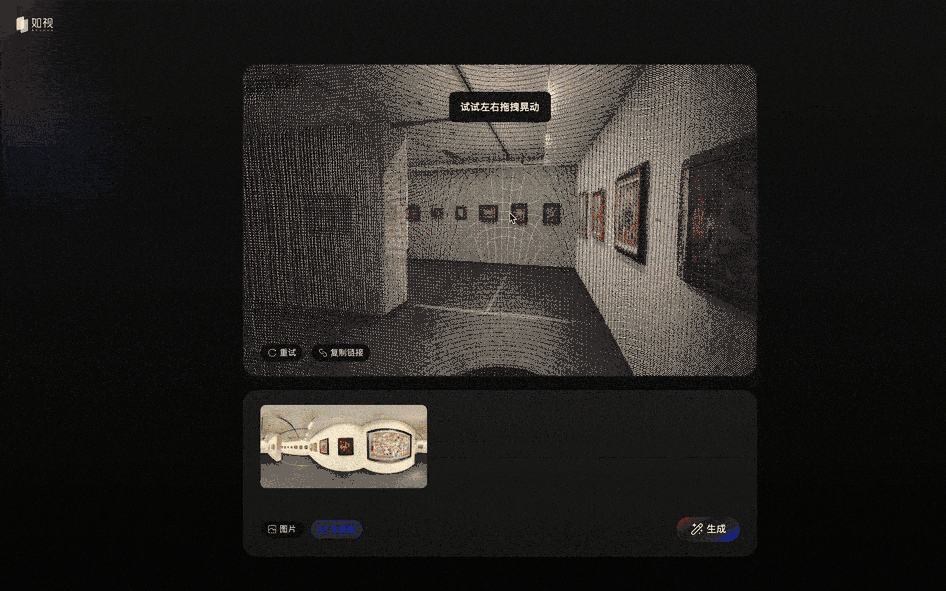
近来,世界模型(World Model)很火。多个 AI 实验室纷纷展示出令人惊艳的 Demo:仅凭一张图片甚至一段文字,就能生成一个可交互、可探索的 3D 世界。这些演示当然很是炫酷,它们展现了 AI 强大的生成能力。
一年半之前,影眸科技年轻的创始团队去到旧金山,带着还没正式发布的 3D 生成模型 Rodin,在 GDC(游戏开发者大会)上向全球最顶级的游戏开发者们演示 demo。
单Transformer搞定任意视图3D重建!
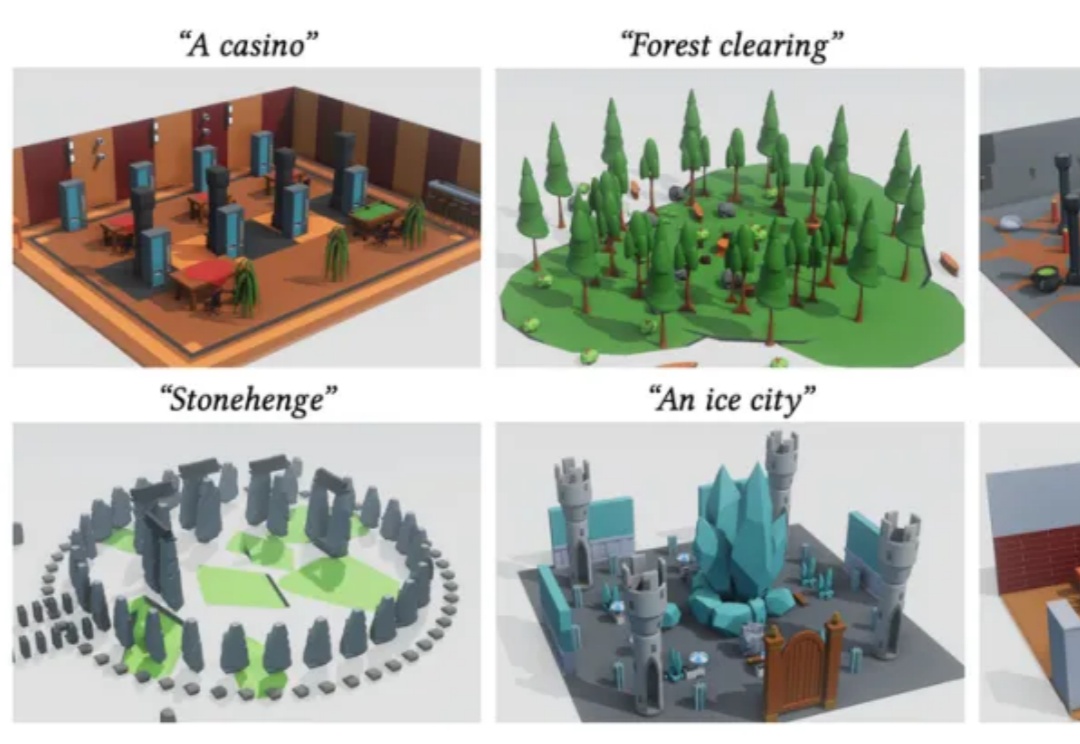
随着生成式 AI 的快速发展,从文本生成图像、视频,到构建完整的三维世界,AI “创造空间” 的能力正以前所未有的速度突破边界。然而,现有 3D 场景生成方法仍存在明显局限:模型往往直接输出每个物体的几何参数(位置、大小、方向等),结果容易出现漂浮、重叠、穿模等问题;场景结构缺乏逻辑一致性,难以编辑或复用,更无法像程序那样精确控制空间关系与生成逻辑。