无奖励也能把Agent练硬,Meta发布早期经验学习,隐式建模+反思(附提示词)
无奖励也能把Agent练硬,Meta发布早期经验学习,隐式建模+反思(附提示词)Meta提出早期经验(Early Experience)让代理在无奖励下从自身经验中学习:在专家状态上采样替代动作、执行并收集未来状态,将这些真实后果当作监督信号。核心是把“自己造成的未来状态”转为可规模化的监督。
来自主题: AI技术研报
10641 点击 2025-10-20 11:54

 搜索
Meta提出早期经验(Early Experience)让代理在无奖励下从自身经验中学习:在专家状态上采样替代动作、执行并收集未来状态,将这些真实后果当作监督信号。核心是把“自己造成的未来状态”转为可规模化的监督。
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
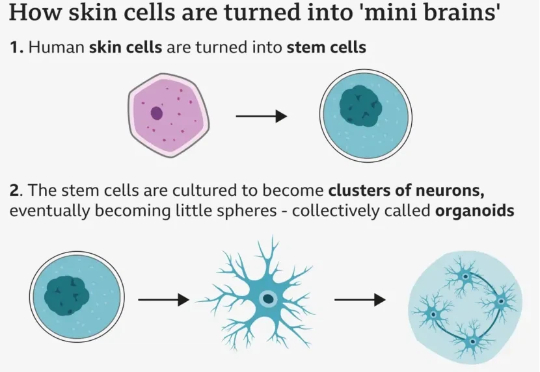
利用人类皮肤细胞也能造出 AI 处理器?一家名为 FinalSpark 的瑞士公司,认为生物计算是 AI 的下一次进化飞跃。该公司开发了一款生物处理器,这些处理器利用人体神经元来代替传统的硅基芯片,使用由人类皮肤细胞培育出的类脑器官作为计算单元。
在近日的一次访谈中,Andrej Karpathy深入探讨了AGI、智能体与AI未来十年的走向。他认为当前的「智能体」仍处早期阶段,强化学习虽不完美,却是目前的最优解。他预测未来10年的AI架构仍然可能是类似Transformer的巨大神经网络。

400元遥操95%机械臂,上海交大推出开源项目U-Arm! 目前它已在XArm6、Dobot CR5、ARX R5等多种机械臂真机上进行了遥操作的验证。
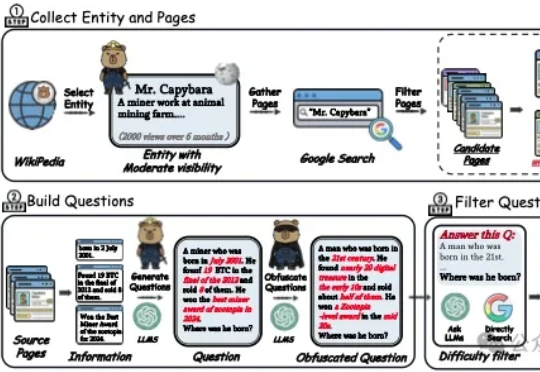
中科院的这篇工作解决了“深度搜索智能体”(deep search agents),两个实打实的工程痛点,一个是问题本身不够难导致模型不必真正思考,另一个是上下文被工具长文本迅速挤爆导致过程提前夭折,研究者直面挑战,从数据和系统两端同时重塑训练与推理流程,让复杂推理既有用又能跑得起来。
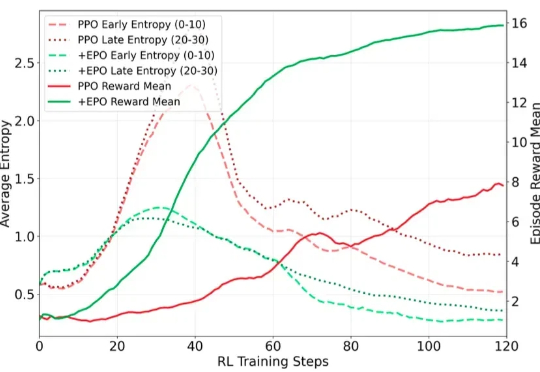
在训练多轮 LLM Agent 时(如需要 30 + 步交互才能完成单个任务的场景),研究者遇到了一个严重的训练不稳定问题:标准的强化学习方法(PPO/GRPO)在稀疏奖励环境下表现出剧烈的熵值震荡,导致训练曲线几乎不收敛。
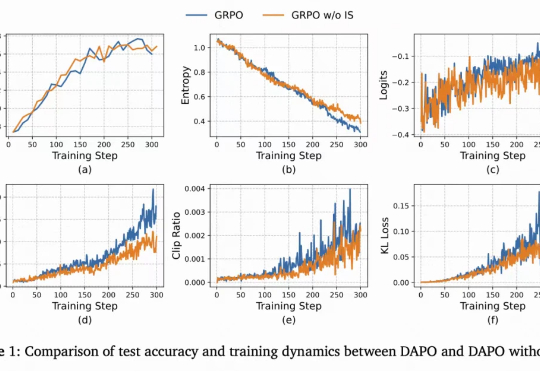
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
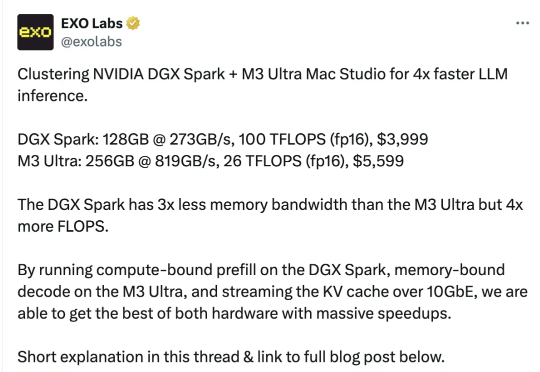
英伟达桌面超算,邪修玩法来了!两台DGX Spark串联一台苹果Mac Studio,就能让大模型推理速度提升至2.77倍。
就在今天,“一家明星具身智能公司原地解散”的传闻在圈内迅速传开,而且因为公司成立时间很短,甚至都不涉及员工赔偿。就在一个多月前,这家公司还高调公开了新融资,以及AI技术大牛加盟作为联合创始人及CTO。