AI资讯新闻榜单内容搜索-ODE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ODE
给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。

来自主题: AI资讯
10938 点击    2026-08-03 16:14
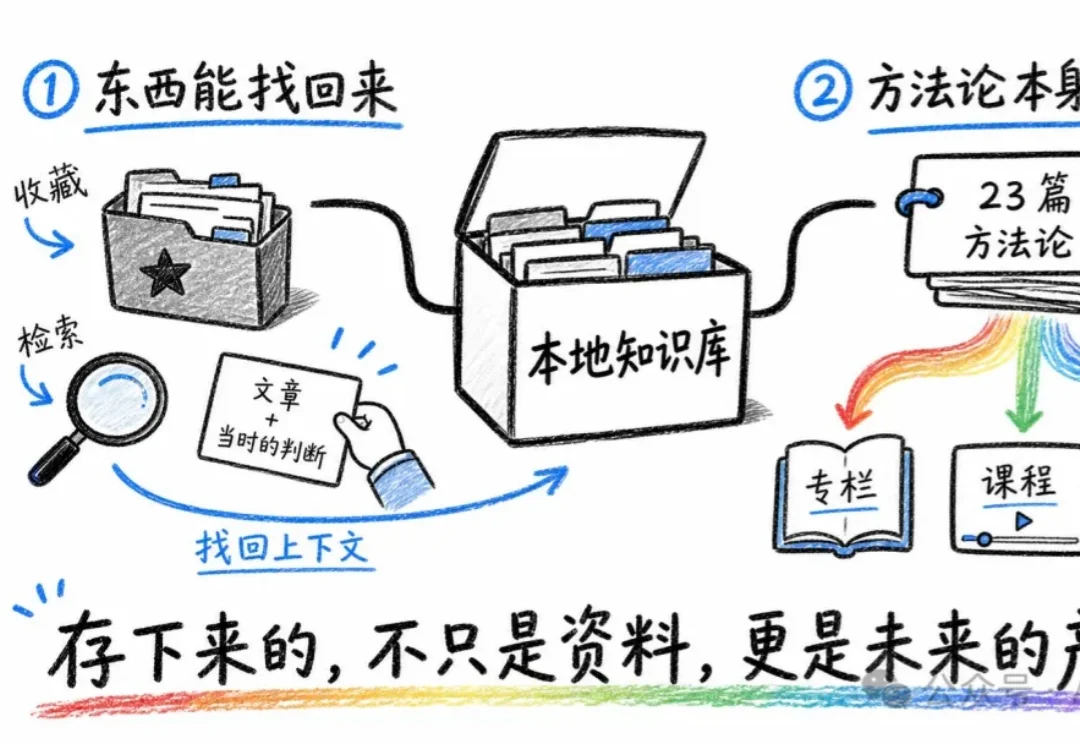
Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。

来自主题: AI技术研报
7745 点击    2026-08-03 15:53
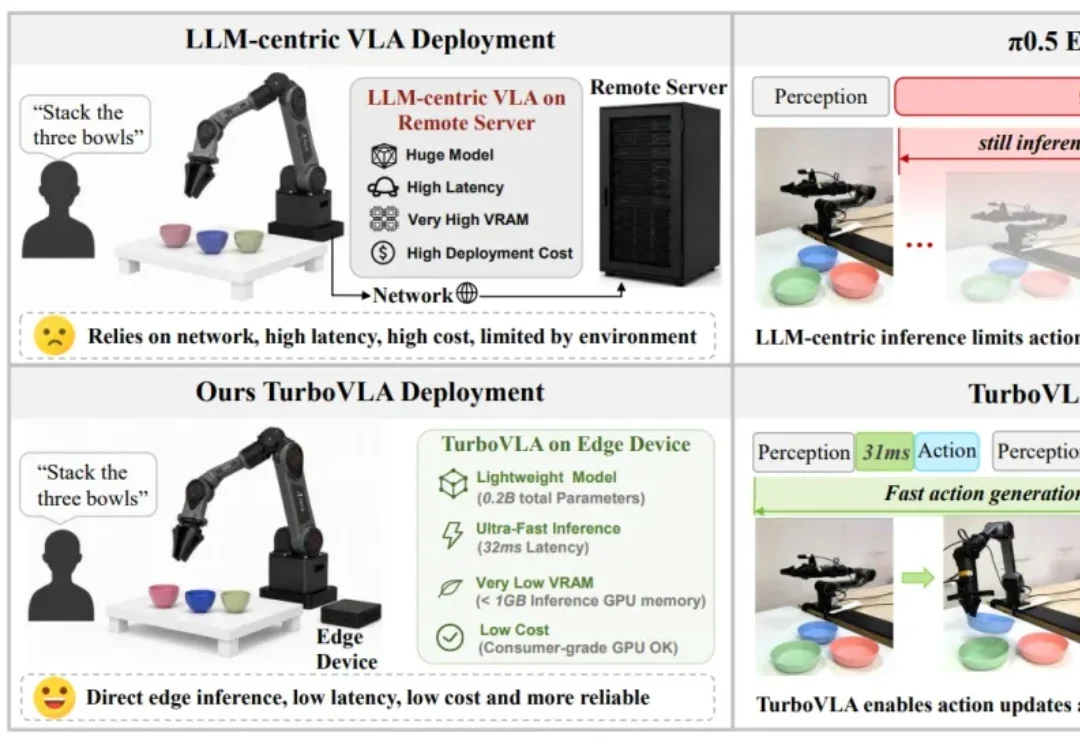
VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。

来自主题: AI技术研报
11040 点击    2026-08-03 15:30
赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

Jay 发自 凹非寺 量子位 | 公众号 QbitAI 啥,谷歌真比OpenAI还早一年搞出了ChatGPT? 不是谷歌事后找补了,这次是OpenAI自己人,Codex负责人Tibo刚佐证的消息: 那

来自主题: AI资讯
9577 点击    2026-08-03 12:27
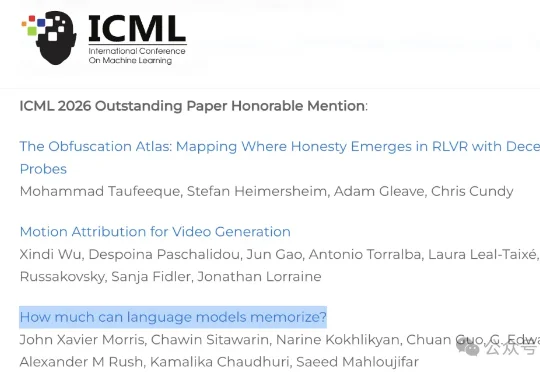
80亿参数记性不如U盘:他算出了大模型记忆天花板

80亿参数记性不如U盘:他算出了大模型记忆天花板

80亿参数记性不如U盘:他算出了大模型记忆天花板

一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。

来自主题: AI技术研报
10015 点击    2026-08-02 22:14
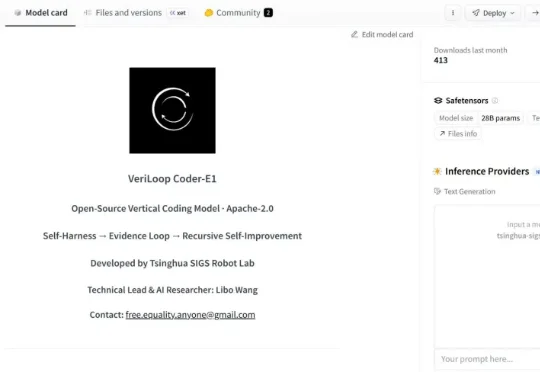
清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

近日,由清华大学深圳国际研究生院智能机器人实验室刘厚德教授领衔、王立博博士后担任 AI 首席研究员的大模型团队,正式发布了 VeriLoop Coder-E1—— 一款基于 Qwen3.6-27B 构建、面向仓库级代码修复与智能体式软件工程任务的开源垂类代码模型。

来自主题: AI技术研报
9728 点击    2026-08-02 13:44
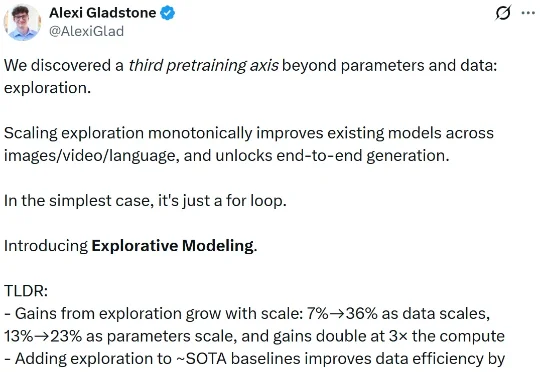
生成模型也能端到端训练了?核心竟是一个for循环

生成模型也能端到端训练了?核心竟是一个for循环

生成模型也能端到端训练了?核心竟是一个for循环

最近,一篇来自 UIUC 与哈佛大学的论文,试图把这块最后的拼图补上。作者给这个新范式起了个名字,叫 Explorative Modeling(探索式建模),模型简称 XM。它的想法简单到近乎朴素,却指向一个大胆的结论:生成模型除了参数和数据,其实还有第三根可以放大的轴。

来自主题: AI技术研报
8402 点击    2026-08-02 11:16
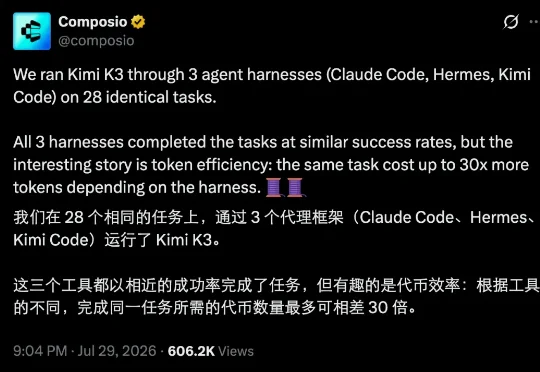
Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。

来自主题: AI资讯
10970 点击    2026-08-01 11:06
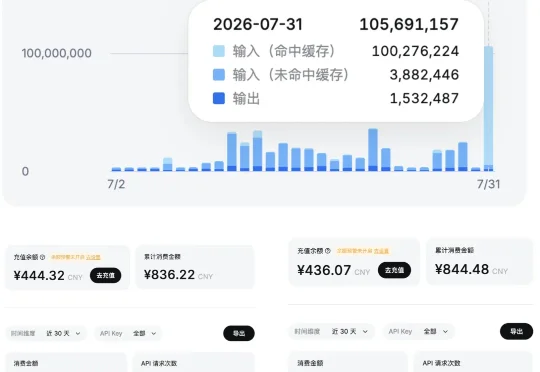
1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论

1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论

1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论

DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。

来自主题: AI产品测评
11747 点击    2026-08-01 10:40
1300 万月活、近 6000 万美元 ARR:OpenCode 如何在 Claude Code、Codex 夹缝中长出来?

1300 万月活、近 6000 万美元 ARR:OpenCode 如何在 Claude Code、Codex 夹缝中长出来?

1300 万月活、近 6000 万美元 ARR:OpenCode 如何在 Claude Code、Codex 夹缝中长出来?

我们整理了最近半年来 OpenCode CEO Jay V 以及联合创始人 Dax Raad 近期在多档播客和访谈中的核心观点,试图还原一个完整的图景,一家开源公司究竟如何在巨头夹缝中找到自己的位置,以及他们怎么看待商业化和模型编排。

来自主题: AI资讯
10550 点击    2026-07-31 21:25