Feed-Forward 3D综述:三维视觉如何「一步到位」
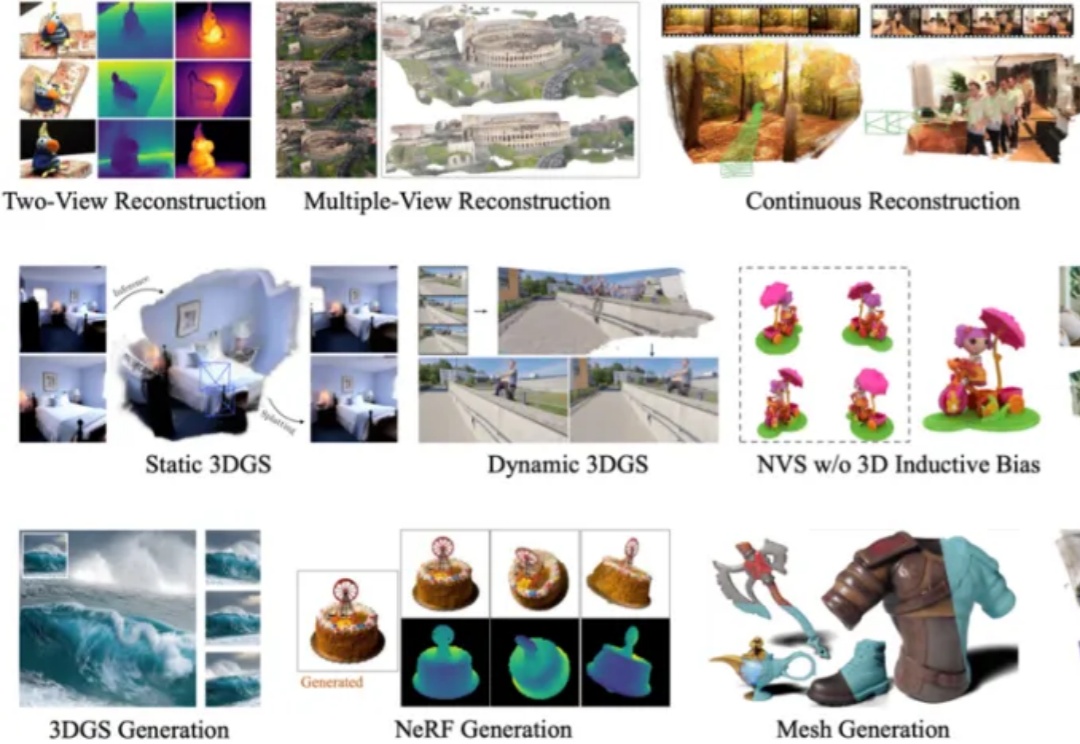
Feed-Forward 3D综述:三维视觉如何「一步到位」在 3D 视觉领域,如何从二维图像快速、精准地恢复三维世界,一直是计算机视觉与计算机图形学最核心的问题之一。从早期的 Structure-from-Motion (SfM) 到 Neural Radiance Fields (NeRF),再到 3D Gaussian Splatting (3DGS),技术的演进让我们离实时、通用的 3D 理解越来越近。
搜索
在 3D 视觉领域,如何从二维图像快速、精准地恢复三维世界,一直是计算机视觉与计算机图形学最核心的问题之一。从早期的 Structure-from-Motion (SfM) 到 Neural Radiance Fields (NeRF),再到 3D Gaussian Splatting (3DGS),技术的演进让我们离实时、通用的 3D 理解越来越近。
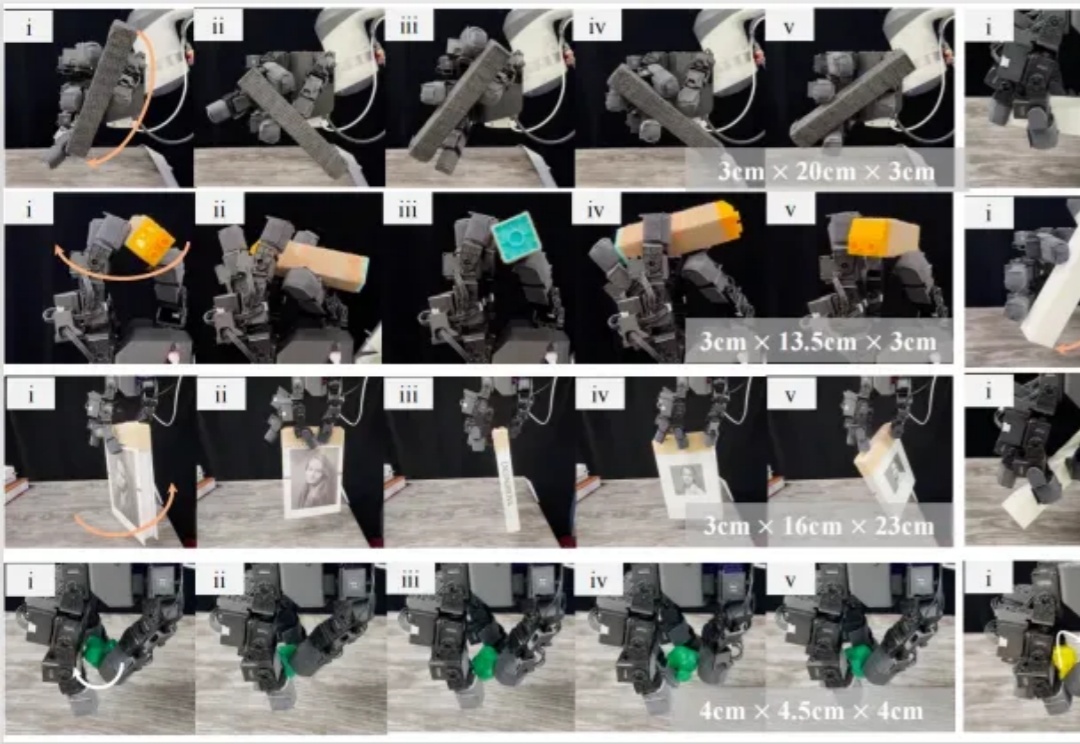
机器人使用灵巧手帮人类在工厂里拧螺丝,在家里切菜做饭的一天何时可以到来?为了实现这一愿景,旨在解决灵巧操作技能 sim-to-real 难题的 DexNDM 应运而生。
如今,一位软件工程师 Teja Kusireddy 用数据扯开了这场“繁荣”背后的部分真相。他对 200 家 AI 公司进行了逆向工程、反编译代码,并追踪 API 调用,发现许多号称“颠覆性创新”的公司,其核心功能仍依赖第三方服务,只是在外层多套了一层“创新”的壳。市场宣传与实际情况之间的差距令人震惊。
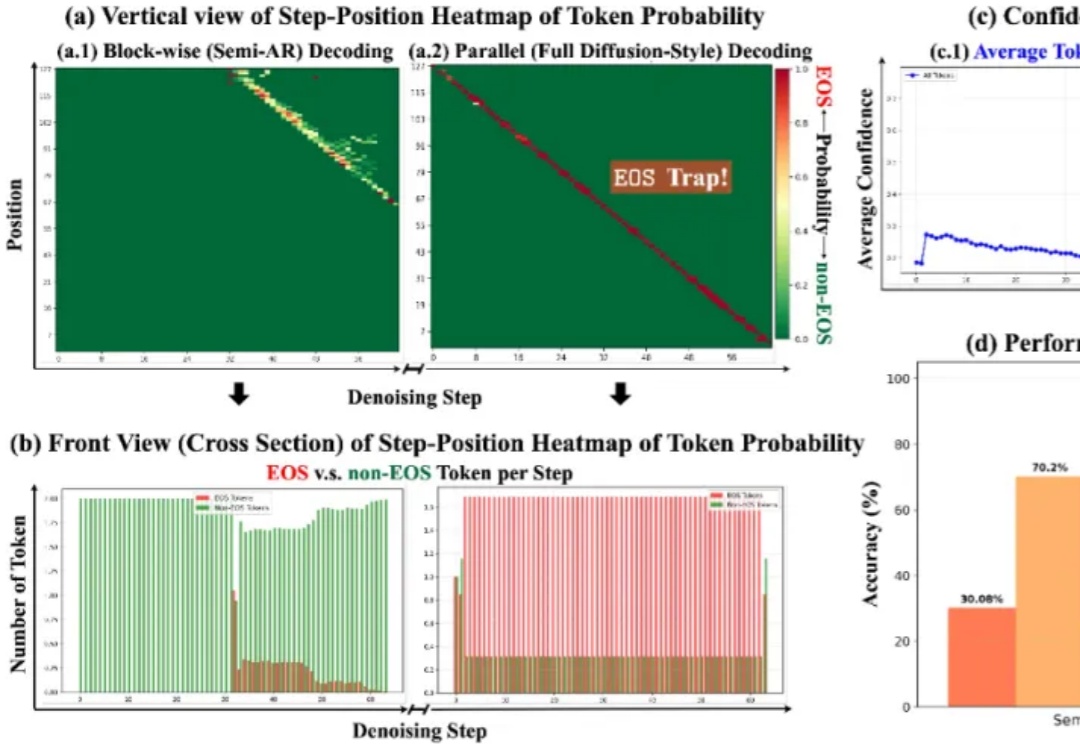
扩散大语言模型得到了突飞猛进的发展,早在 25 年 2 月 Inception Labs 推出 Mercury—— 第一个商业级扩散大型语言模型,同期人民大学发布第一个开源 8B 扩散大语言模型 LLaDA,5 月份 Gemini Diffusion 也接踵而至。
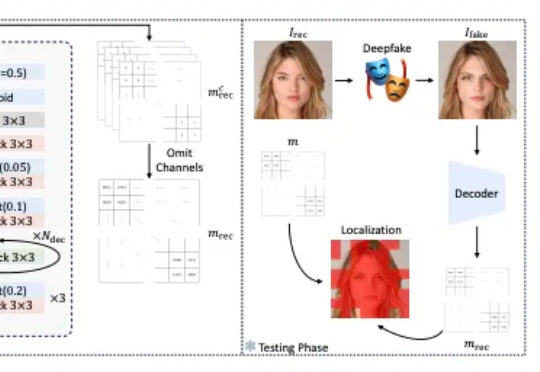
该论文提出 FractalForensics,一种基于分形水印的主动深度伪造检测与定位方法。不同于以往的水印向量,为达成伪造定位的功能,论文提出的水印以矩阵形式出现。
如果我不说,你能分清哪个是马斯克本人的声音吗?
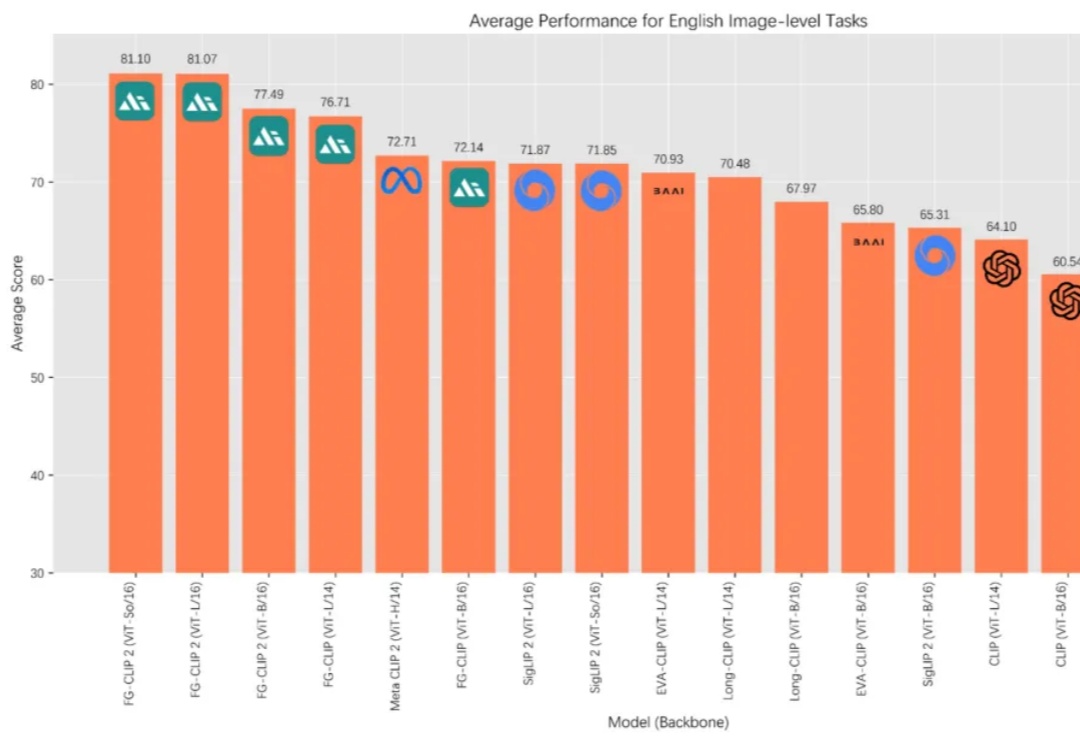
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
奥特曼正在用万亿美金的算力豪赌,试图买下全球GPU来喂饱「增长黑洞」。为什么AI竞争的终局不是模型,而是算力?
近日,上海人工智能实验室针对该难题提出全新范式 SDAR (Synergistic Diffusion-AutoRegression)。该方法通过「训练-推理解耦」的巧妙设计,无缝融合了 AR 模型的高性能与扩散模型的并行推理优势,能以极低成本将任意 AR 模型「改造」为并行解码模型。
10 月 30 日,据彭博社援引知情人士报道,英伟达计划向人工智能初创公司 Poolside 投资最高达 10 亿美元,这笔交易预计将使后者的估值翻四倍。消息人士称,Poolside 目前正在洽谈一轮新融资,拟以 120 亿美元的投前估值融资 20 亿美元。其中,英伟达计划出资至少 5 亿美元,若本轮融资顺利完成,英伟达的总投资额可能达到 10 亿美元。