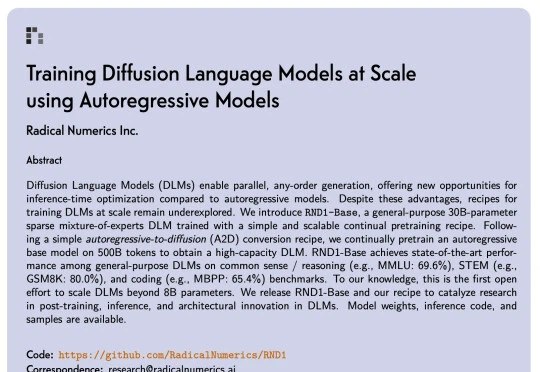
Qwen3 变身扩散语言模型?不从零训练也能跑,30B参数创纪录
Qwen3 变身扩散语言模型?不从零训练也能跑,30B参数创纪录扩散语言模型(Diffusion Language Models,DLM)一直以来都令研究者颇感兴趣,因为与必须按从左到右顺序生成的自回归模型(Autoregressive, AR)不同,DLM 能实现并行生成,这在理论上可以实现更快的生成速度,也能让模型基于前后文更好地理解生成语境。
搜索
扩散语言模型(Diffusion Language Models,DLM)一直以来都令研究者颇感兴趣,因为与必须按从左到右顺序生成的自回归模型(Autoregressive, AR)不同,DLM 能实现并行生成,这在理论上可以实现更快的生成速度,也能让模型基于前后文更好地理解生成语境。
LLaVA 于 2023 年提出,通过低成本对齐高效连接开源视觉编码器与大语言模型,使「看图 — 理解 — 对话」的多模态能力在开放生态中得以普及,明显缩小了与顶级闭源模型的差距,标志着开源多模态范式的重要里程碑。
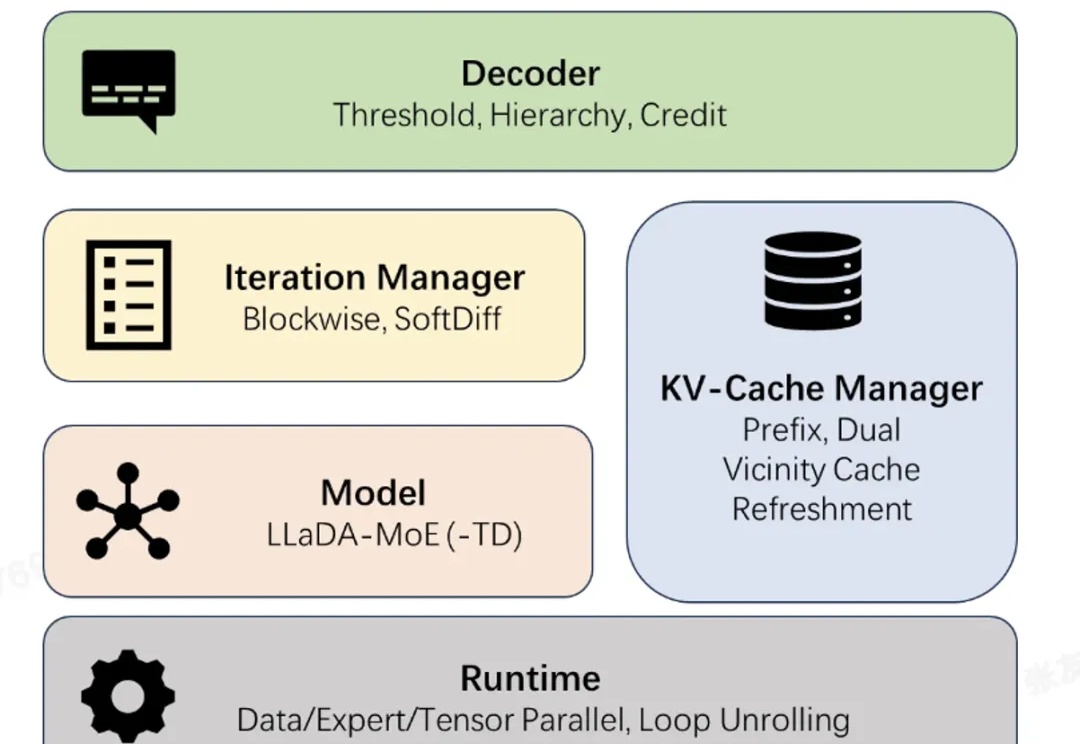
近日,蚂蚁集团正式开源业界首个高性能扩散语言模型(Diffusion Large Language Model,dLLM)推理框架 dInfer。
谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。
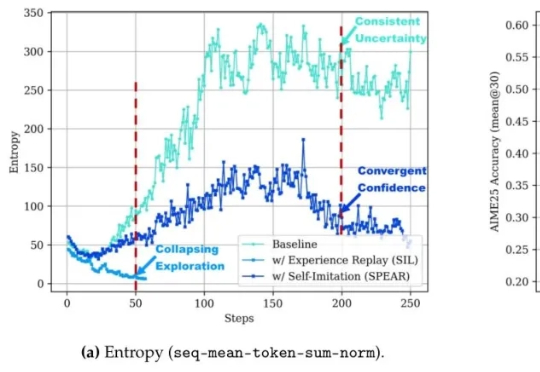
让智能体自己摸索新方法,还模仿自己的成功经验。腾讯优图实验室开源强化学习算法——SPEAR(Self-imitation with Progressive Exploration for Agentic Reinforcement Learning)。
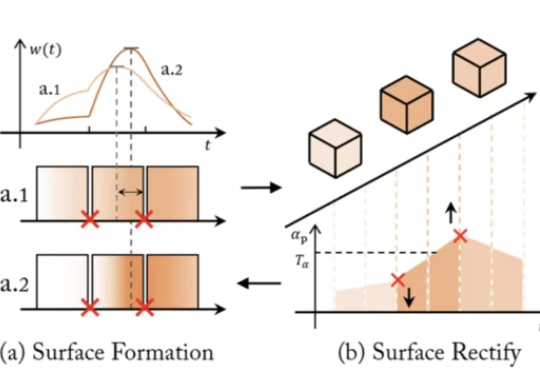
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
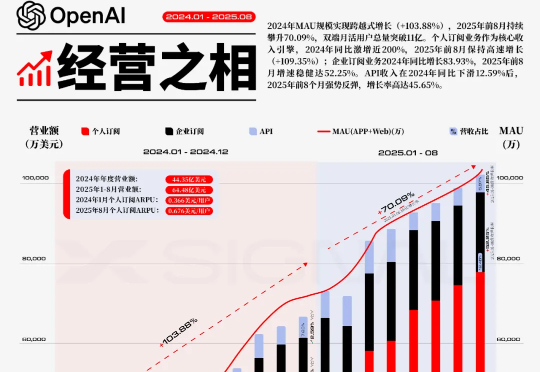
2022年11月,OpenAI的ChatGPT问世,这一事件不仅是技术创新的里程碑,更被视为重塑全球AI战略版图的关键转折点,它标志着新一轮大国AI竞赛的序幕被正式拉开。在此背景下,其增长的规模与速度本身,就是一种颠覆性的战略壁垒。
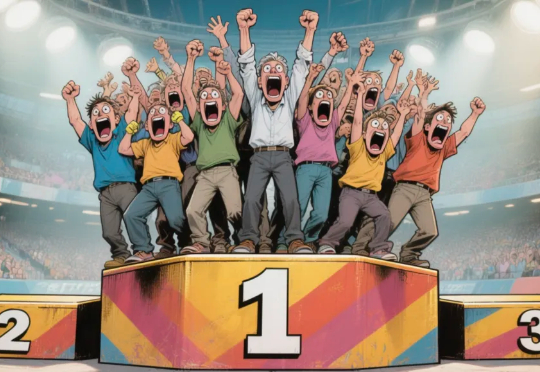
最近,两条消息同时刷屏:先是 9 月 23 日快手宣布其可灵 2.5 Turbo 图生/文生视频模型,推出 10 天后,即在 Artificial Analysis 上成为世界第一;紧接着,腾讯也宣布混元图像 3.0 模型在 LMArena 上成为世界第一。
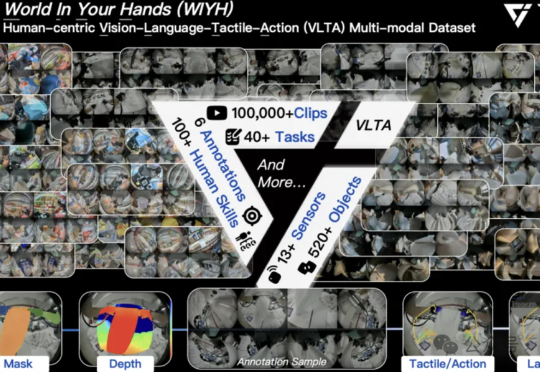
全球首个真实世界具身多模态数据集,它来了! 刚刚,它石智航发布全球首个大规模真实世界具身VLTA(Vision-Language-Tactile-Action)多模态数据集World In Your Hands(WIYH)。
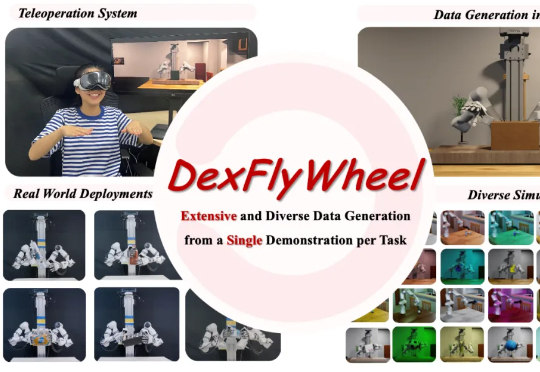
近期,北京大学、哈尔滨工业大学联合 PsiBot 灵初智能提出首个自我增强的灵巧操作数据生成框架 ——DexFlyWheel。该框架仅需单条演示即可启动任务,自动生成多样化的灵巧操作数据,旨在缓解灵巧手领域长期存在的数据稀缺问题。目前已被 NeurIPS 2025 接受为 Spotlight(入选率约 3.2%)