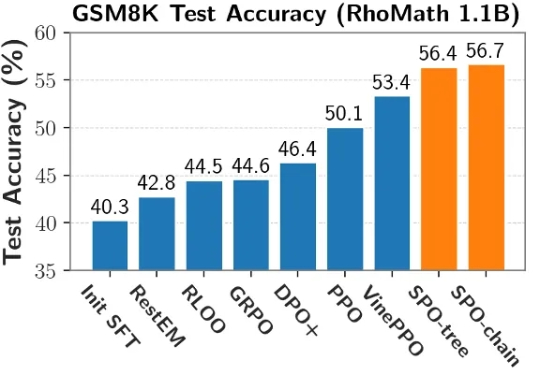
大模型强化学习新突破——SPO新范式助力大模型推理能力提升!
大模型强化学习新突破——SPO新范式助力大模型推理能力提升!当前,强化学习(RL)在提升大语言模型(LLM)推理能力方面展现出巨大潜力。DeepSeek R1、Kimi K1.5 和 Qwen 3 等模型充分证明了 RL 在增强 LLM 复杂推理能力方面的有效性。
来自主题: AI技术研报
11086 点击 2025-06-09 11:02

 搜索
当前,强化学习(RL)在提升大语言模型(LLM)推理能力方面展现出巨大潜力。DeepSeek R1、Kimi K1.5 和 Qwen 3 等模型充分证明了 RL 在增强 LLM 复杂推理能力方面的有效性。

上周,AI 视频生成工具 Medeo[1] 发布,用户输入文字描述,它会自动完成拆分镜头、生成脚本、添加音乐和生成视频等一系列操作,当天在我们的朋友圈里引发了小型「刷屏」。
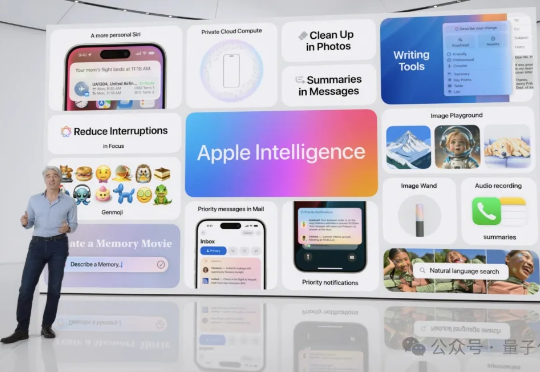
苹果最新大模型论文,在AI圈炸开了锅。 有人总结到:苹果刚刚当了一回马库斯,否定了所有大模型的推理能力。

模型卷得差不多了,AI硬件竞争开启了。Google前脚刚在I/O大会上预告,整合了Gemini AI的Android XR设备即将问世;OpenAI就紧随其后,宣布将以近65亿美元(约合人民币468亿元)的全股权交易方式,收购一家硬件初创公司IO。
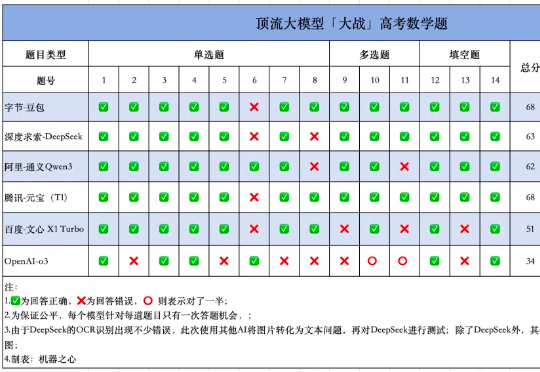
还在让大模型写高考作文?有本事做高考数学卷子。 又是一年高考时。 这届考生上午刚经历了抽象作文的洗礼,下午又被数学无情创飞。

只要你做过活检,那么你(至少是你的组织样本)就一定经受过病理学家的诊断。正如加拿大多伦多大学的计算机科学家王博(Bo Wang)所说,“病理学是当代医学诊断的基石,在癌症诊断方面尤其如此。”
本文内容整理自 ProtonBase CEO 王绍翾在 AICon 的主题演讲《Data Warebase: Instant Ingest-Transform-Explore-Retrieve for AI Applications》。
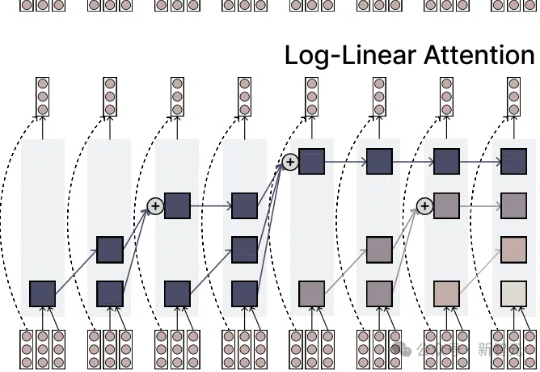
注意力机制的「平方枷锁」,再次被撬开!一招Fenwick树分段,用掩码矩阵,让注意力焕发对数级效率。更厉害的是,它无缝对接线性注意力家族,Mamba-2、DeltaNet 全员提速,跑分全面开花。长序列处理迈入log时代!
企业级低代码开发平台Superblocks 的 CEO 布拉德·梅内塞斯认为,下一批价值十亿美元的创业点子几乎就藏在眼前:现有 AI 独角兽企业所使用的系统提示词中。
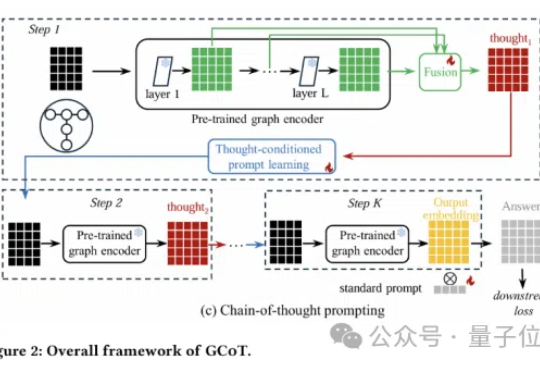
图神经网络还能更聪明?思维链提示学习来了!