刚刚,Mistral AI最新磁力链放出!8x22B MoE模型,281GB解禁
刚刚,Mistral AI最新磁力链放出!8x22B MoE模型,281GB解禁一条磁力链,Mistral AI又来闷声不响搞事情。
来自主题: AI资讯
8245 点击 2024-04-11 16:39

 搜索
一条磁力链,Mistral AI又来闷声不响搞事情。
不得不感叹,国外AI大模型的迭代速度,就像是坐火箭????。
技术阿甘在不停奔跑。
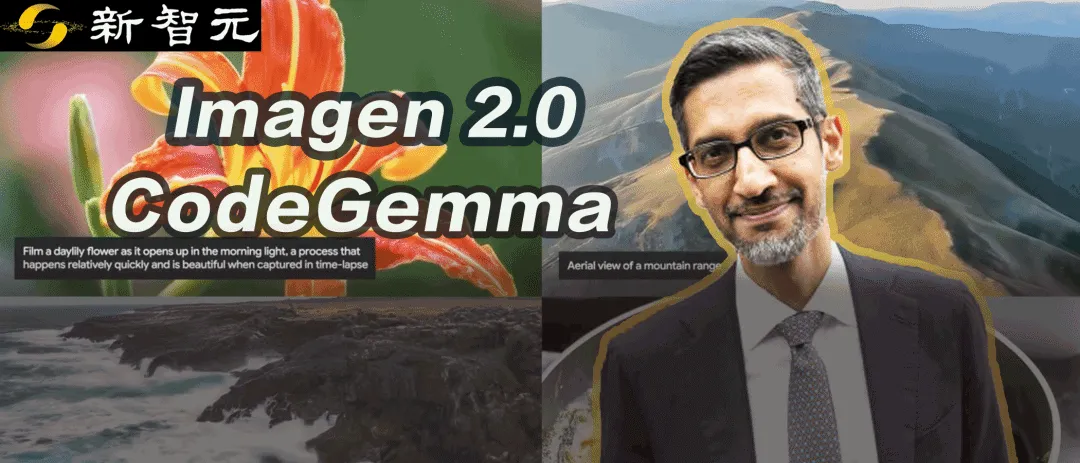
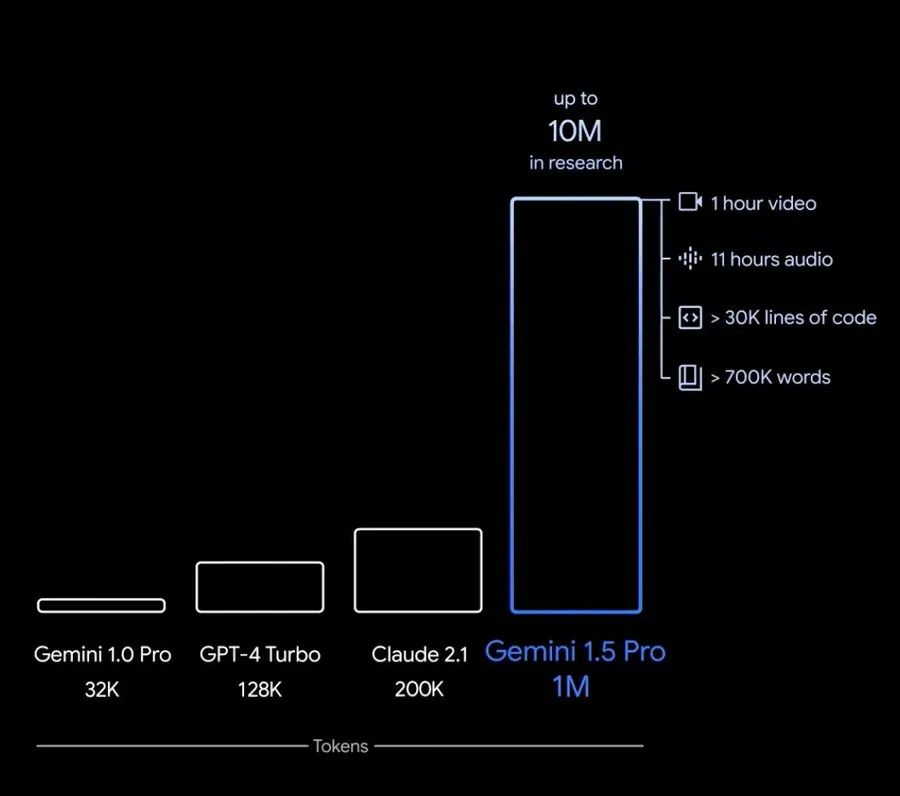
昨天的谷歌Next大会可是太精彩了,谷歌一连放出不少炸弹。 - 升级「视频版」Imagen 2.0,下场AI视频模型大混战 - 发布时被Sora光环掩盖的Gemini 1.5 Pro,正式开放 - 首款Arm架构CPU发布,全面对垒微软/亚马逊/英伟达/英特尔

Stable Diffusion数位核心开发者离职,紧接着该公司创始人、首席执行官Emad Mostaque宣布卸任相关职务,并表示未来将专注开发去中心化AI。如今更是有消息称,据Stability AI内部文件和数十位知情人士透露,该公司的现金储备已经枯竭。
GPT-4问世一年后,全世界已经到处都是GPT-4级别的大模型了。 尤其是最近几个月,这些模型以越发密集的频率现身
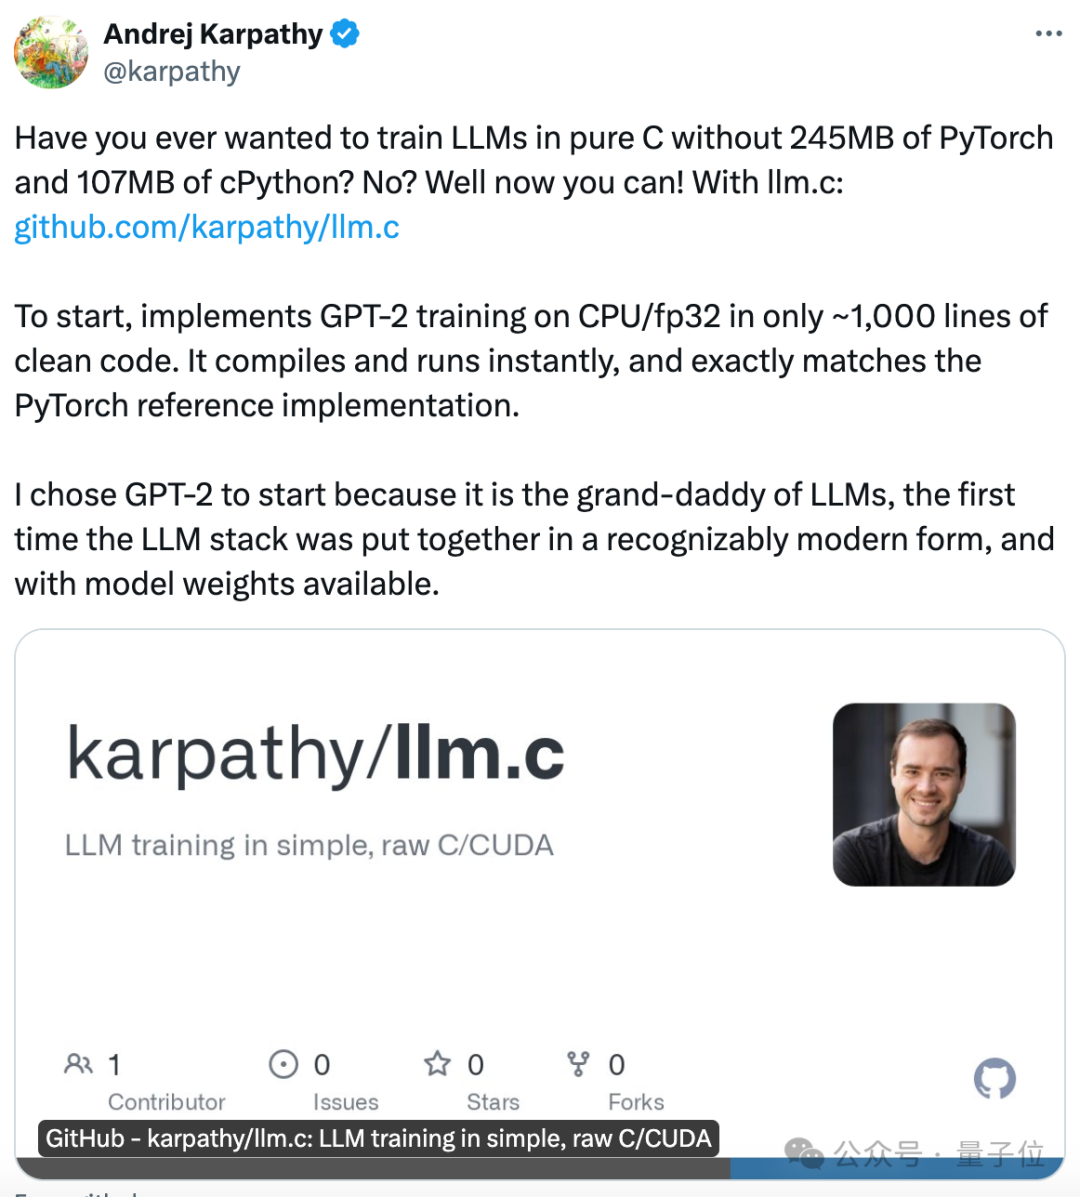
纯C语言训练GPT,1000行代码搞定!,不用现成的深度学习框架,纯手搓。 发布仅几个小时,已经揽星2.3k。
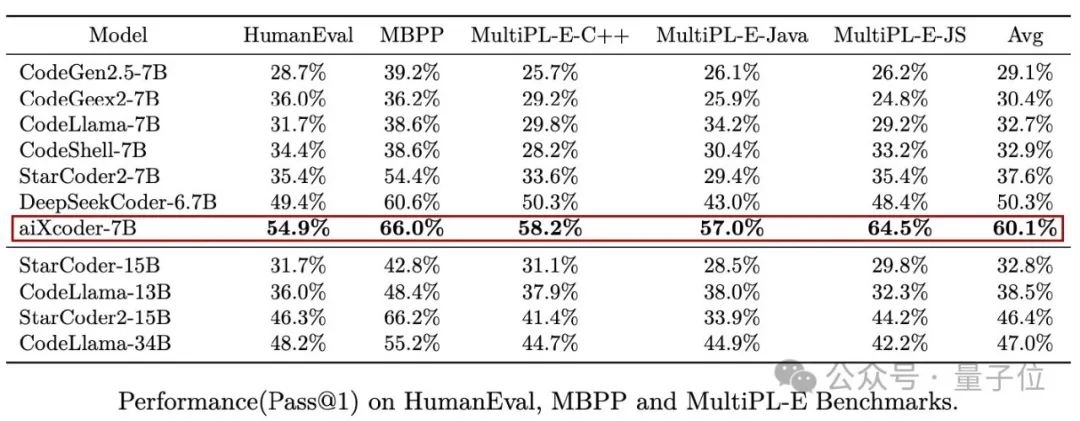
来自Meta、基于Llama2,可是开源界最先进的AI编程大模型之作
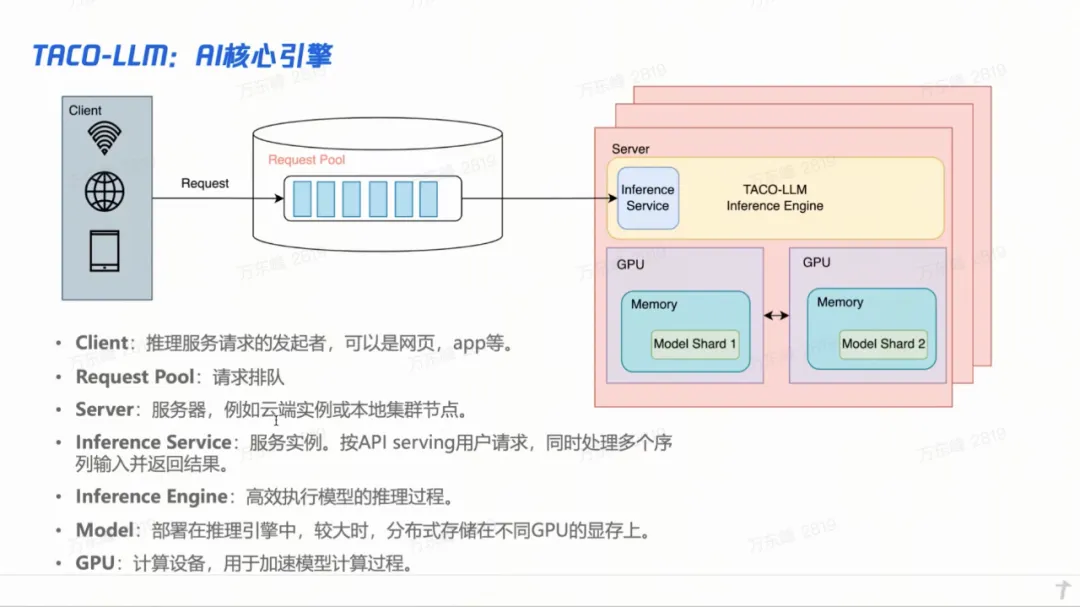
大模型在今年的落地,除了对用 AI 对已有业务进行改造和提效外,算力和推理的优化,可能是另外一项重要的实践了。这在腾讯的两个完全不同的业务上有着明显的体现。
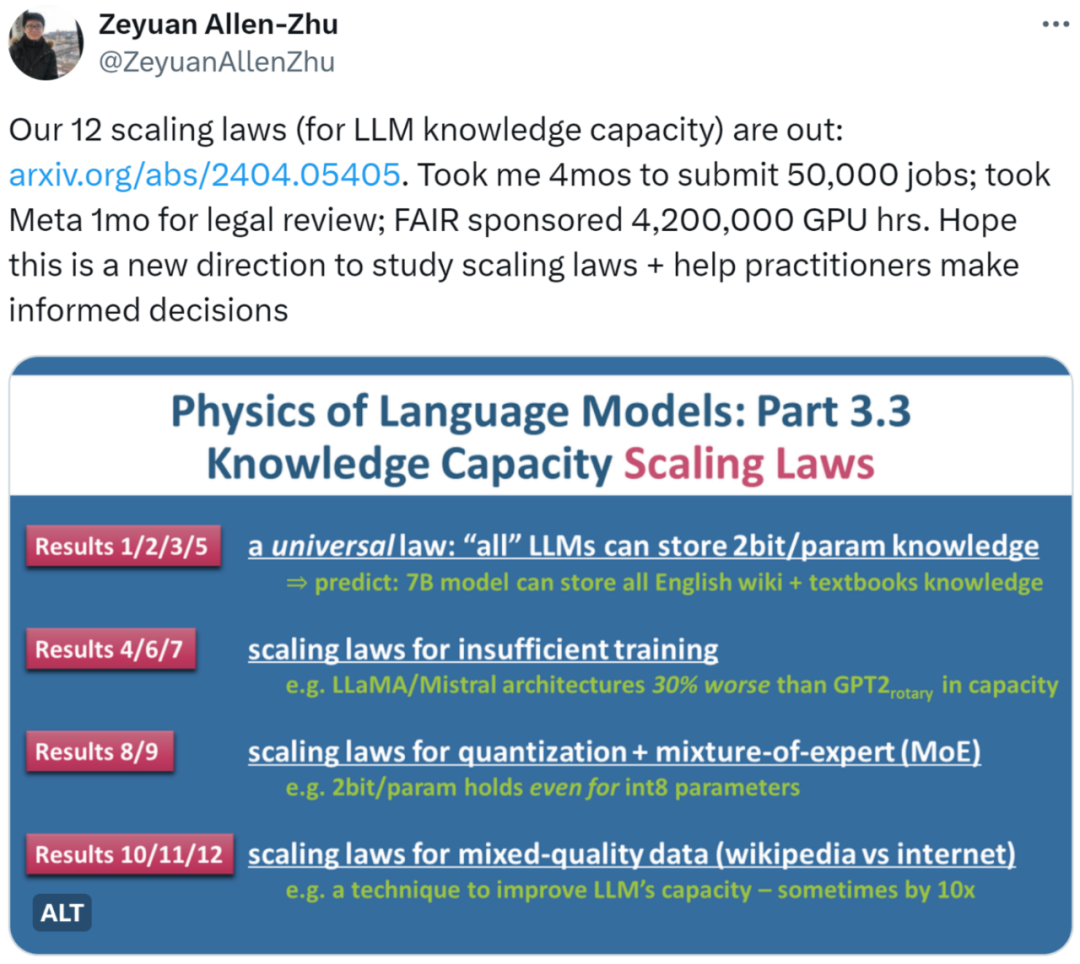
近日,朱泽园 (Meta AI) 和李远志 (MBZUAI) 的最新研究《语言模型物理学 Part 3.3:知识的 Scaling Laws》用海量实验(50,000 条任务,总计 4,200,000 GPU 小时)总结了 12 条定律,为 LLM 在不同条件下的知识容量提供了较为精确的计量方法。