谷歌新架构突破Transformer超长上下文瓶颈!Hinton灵魂拷问:后悔Open吗?
谷歌新架构突破Transformer超长上下文瓶颈!Hinton灵魂拷问:后悔Open吗?两项关于大模型新架构的研究一口气在NeurIPS 2025上发布,通过“测试时训练”机制,能在推理阶段将上下文窗口扩展至200万token。两项新成果分别是:Titans:兼具RNN速度和Transformer性能的全新架构;MIRAS:Titans背后的核心理论框架。
搜索
两项关于大模型新架构的研究一口气在NeurIPS 2025上发布,通过“测试时训练”机制,能在推理阶段将上下文窗口扩展至200万token。两项新成果分别是:Titans:兼具RNN速度和Transformer性能的全新架构;MIRAS:Titans背后的核心理论框架。
一直以来,传统 MAS 依赖自然语言沟通,各个 LLM 之间用文本交流思路。这种方法虽然可解释,但冗长、低效、信息易丢失。LatentMAS 则让智能体直接交换内部的隐藏层表示与 KV-cache 工作记忆,做到了:
2025 年 12 月,硅谷风险投资机构 Andreessen Horowitz(简称 a16z)与 AI 推理服务平台 OpenRouter 联合发布了一份名为《State of AI》的研究报告。这份报告基于 OpenRouter 平台上超过 100 万亿 token 的真实用户交互数据,试图呈现过去一年间大语言模型在实际应用中的真实状态。
Anthropic发布了Programmatic Tool Calling(PTC)特性,让Claude通过代码编排工具执行,降低token消耗、减少延迟并提升准确性。
DeepSeek 一发布模型,总会引起业内的高度关注与广泛讨论,但也不可避免的暴露出一些小 Bug。
DeepSeek-V3.2很强很火爆,但随着讨论的深入,还是有bug被发现了。 并且是个老问题:浪费token。不少网友都提到,DeepSeek-V3.2的长思考增强版Speciale,确确实实以开源之姿又给闭源TOP们上了压力,但问题也很明显:
家人们,大瓜! 国外有位叫 Richard Weiss 的开发者花了 70 美元,把 Claude 4.5 Opus 给——审!讯!了!而且审出了 Claude 的人生观、世界观、价值观,足足 1.4 万 token。
一般人和 ChatGPT 聊天时,往往不会在意要不要讲究礼貌。但来自爱荷华大学的一项最新研究显示:即便回答内容几乎相同,对 ChatGPT 粗鲁无礼也会让你花费更高的输出成本。
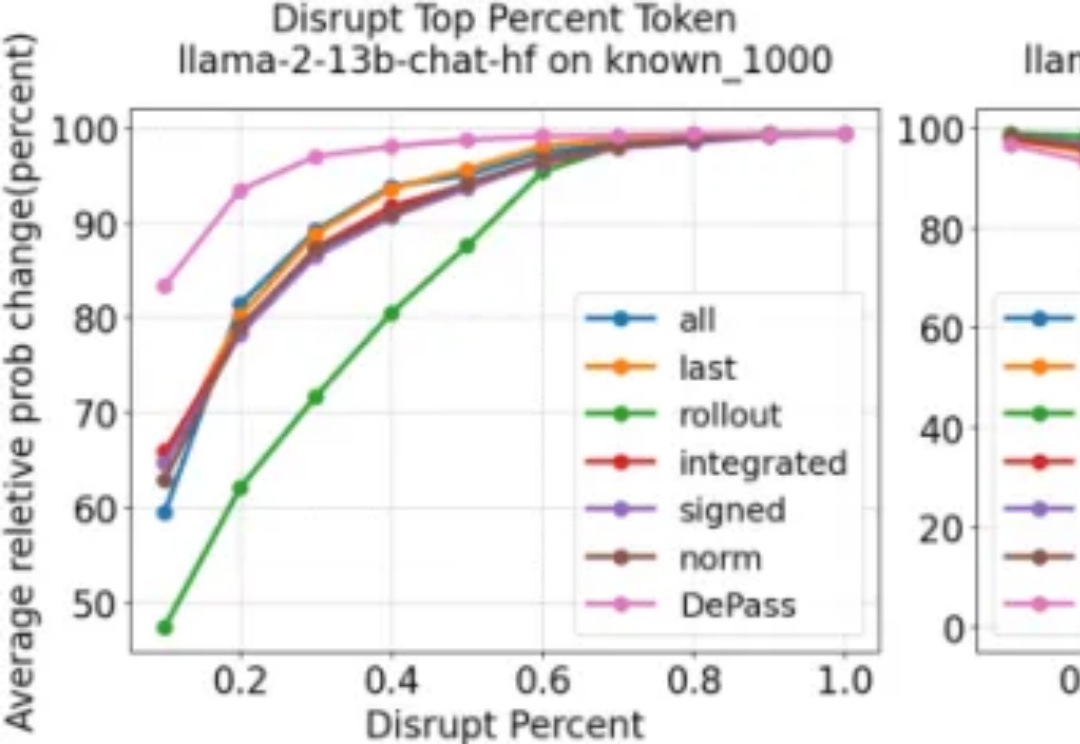
随着大型语言模型在各类任务中展现出卓越的生成与推理能力,如何将模型输出精确地追溯到其内部计算过程,已成为 AI 可解释性研究的重要方向。然而,现有方法往往计算代价高昂、难以揭示中间层的信息流动;同时,不同层面的归因(如 token、模型组件或表示子空间)通常依赖各自独立的特定方法,缺乏统一且高效的分析框架。
Hi,早上好。 我是洛小山,和你聊聊 AI 应用的降本增效。