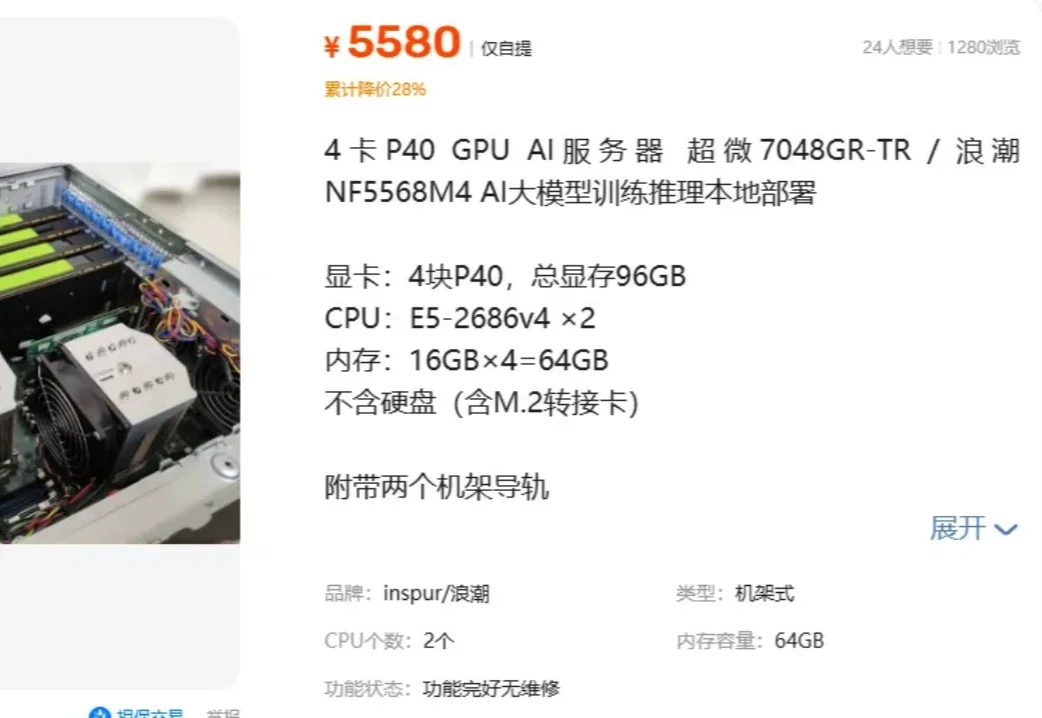
5580元!闲鱼流出96GB显存整机,本地部署AI大模型有着落了!
5580元!闲鱼流出96GB显存整机,本地部署AI大模型有着落了!5580元,四张24GB P40,合计96GB显存。老计算卡就这么水灵灵地又上岗了。 这条闲鱼商品,卖家标称双路E5-2686 v4、64GB内存,不含硬盘,附M.2转接卡和导轨,仅限南京自提。
来自主题: AI资讯
7980 点击 2026-11-03 15:14

 搜索
5580元,四张24GB P40,合计96GB显存。老计算卡就这么水灵灵地又上岗了。 这条闲鱼商品,卖家标称双路E5-2686 v4、64GB内存,不含硬盘,附M.2转接卡和导轨,仅限南京自提。
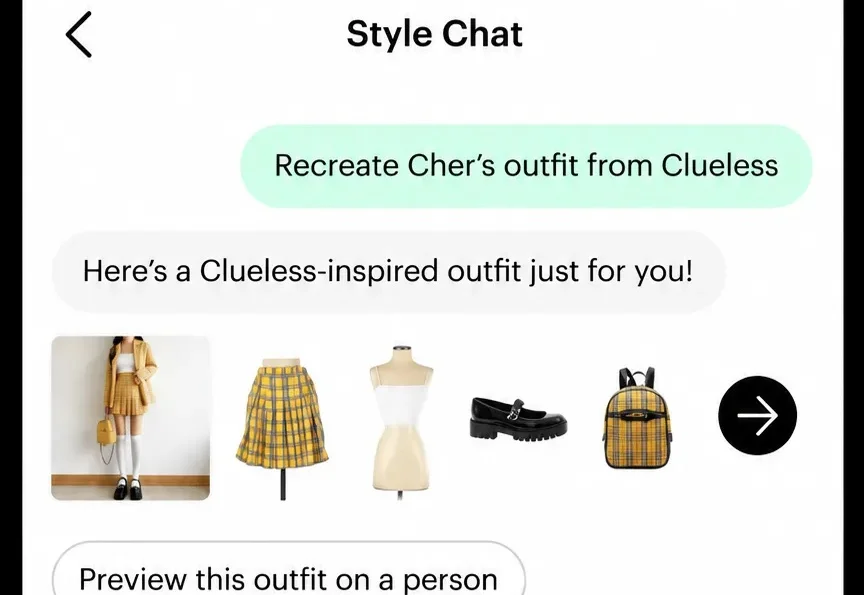
你的旧衣服怎么处理的?
上周五,我写了一篇关于B站鱼灾的文章DeepSeek的尽头,居然是一条会喊你爸爸的蓝色大肥鱼,不少朋友在评论区和私信里问要怎么养鱼。
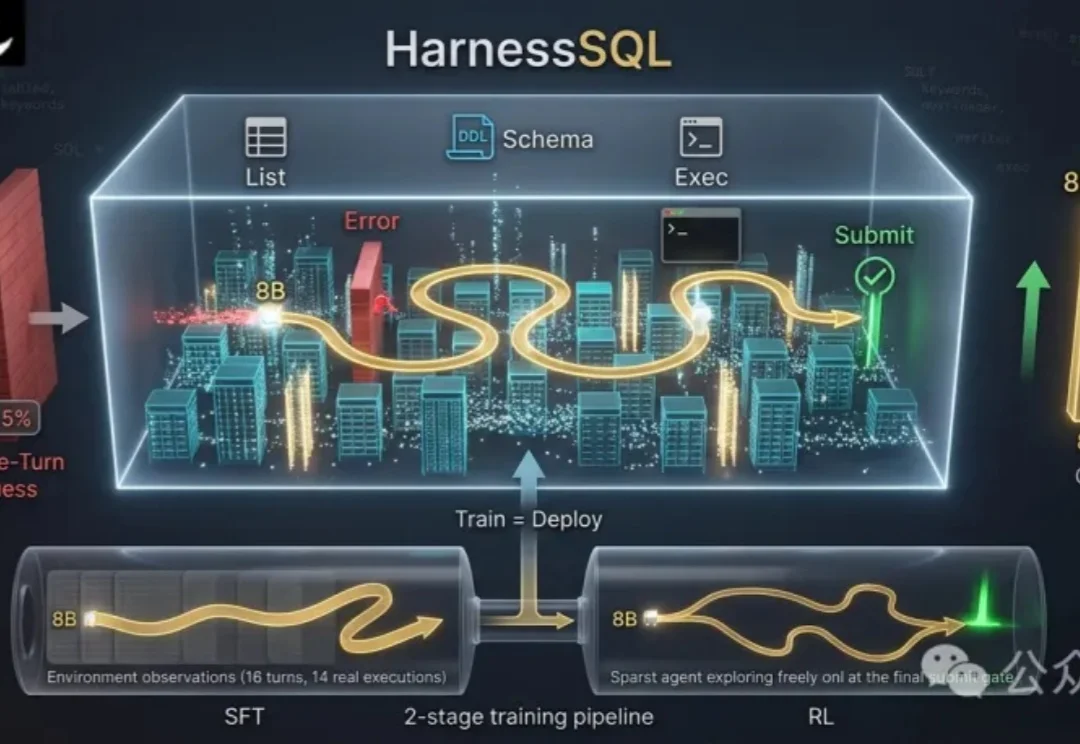
在企业级真实业务与复杂数据分析中,让大模型「一眼看穿数据库并写出完美SQL」,往往只是一个不切实际的幻想。
用螺丝刀拧紧螺丝,听起来并不复杂。
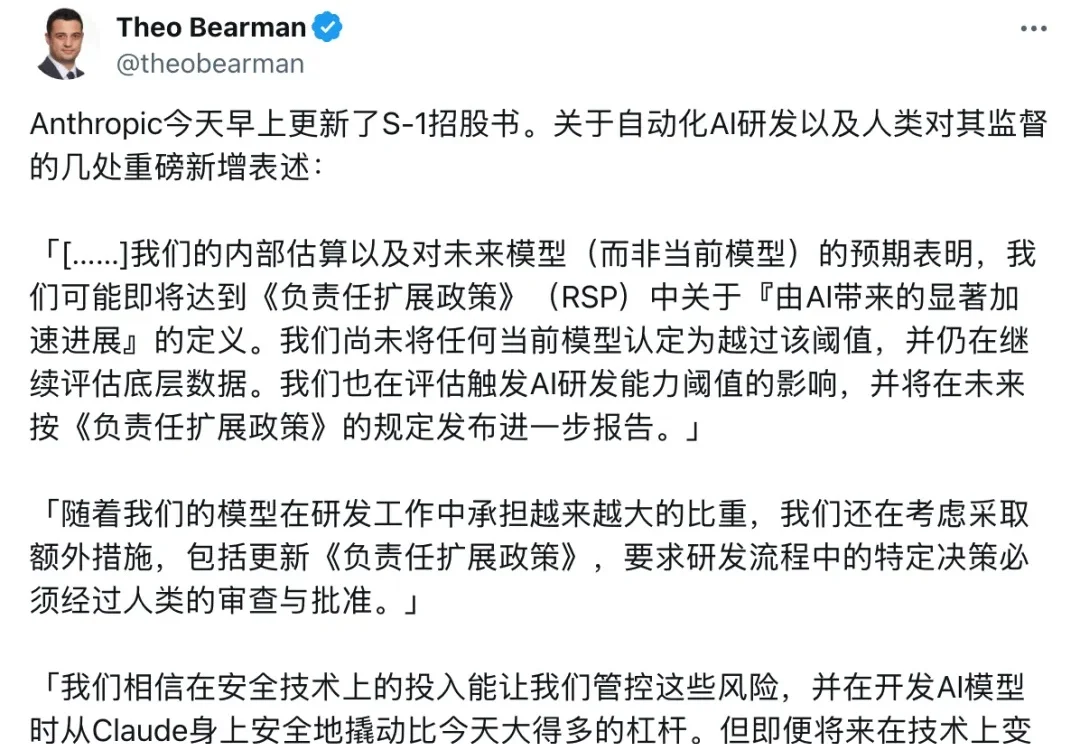
造AI的人,已来不及看清AI进化到了哪一步!
“你要不要上车?”
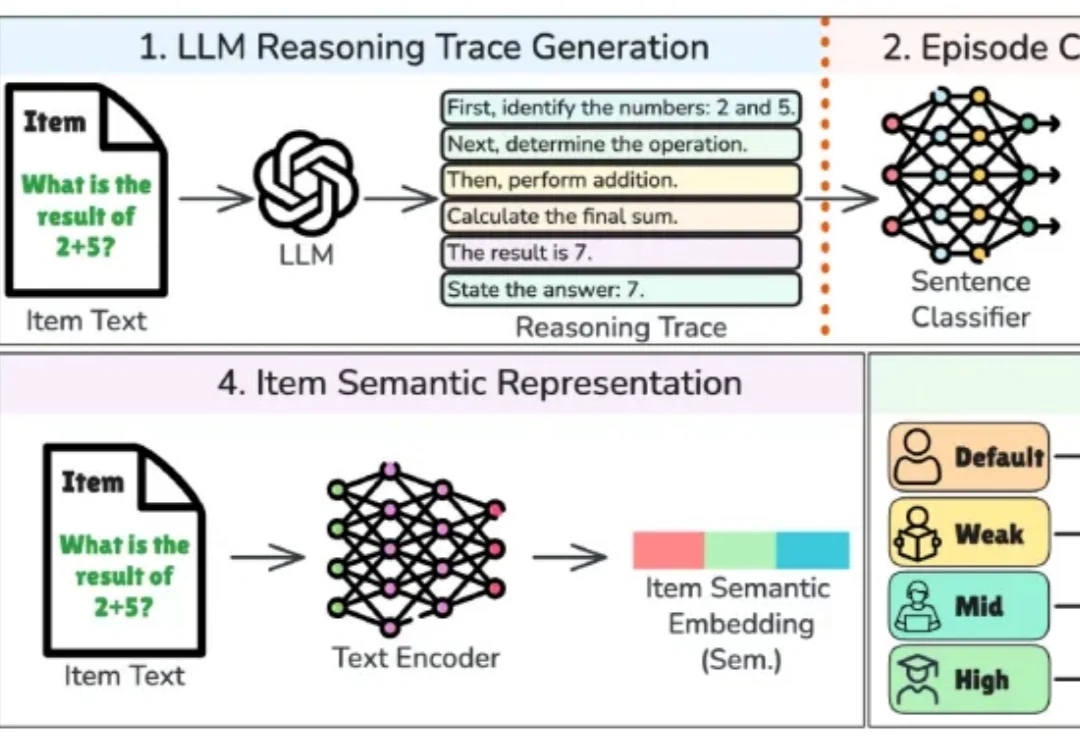
一道试题对人来说有多难,能否从大模型的解题过程中找到线索?
Anthropic早期员工Ivan Vendrov在《Some Memories of Early Anthropic》中回忆,入职八个月后因AI安全使命与商业化、模型竞赛压力带来的精神重压选择离开,并质疑公司将谨慎服从的助手塑造为“受过创伤的官僚”。
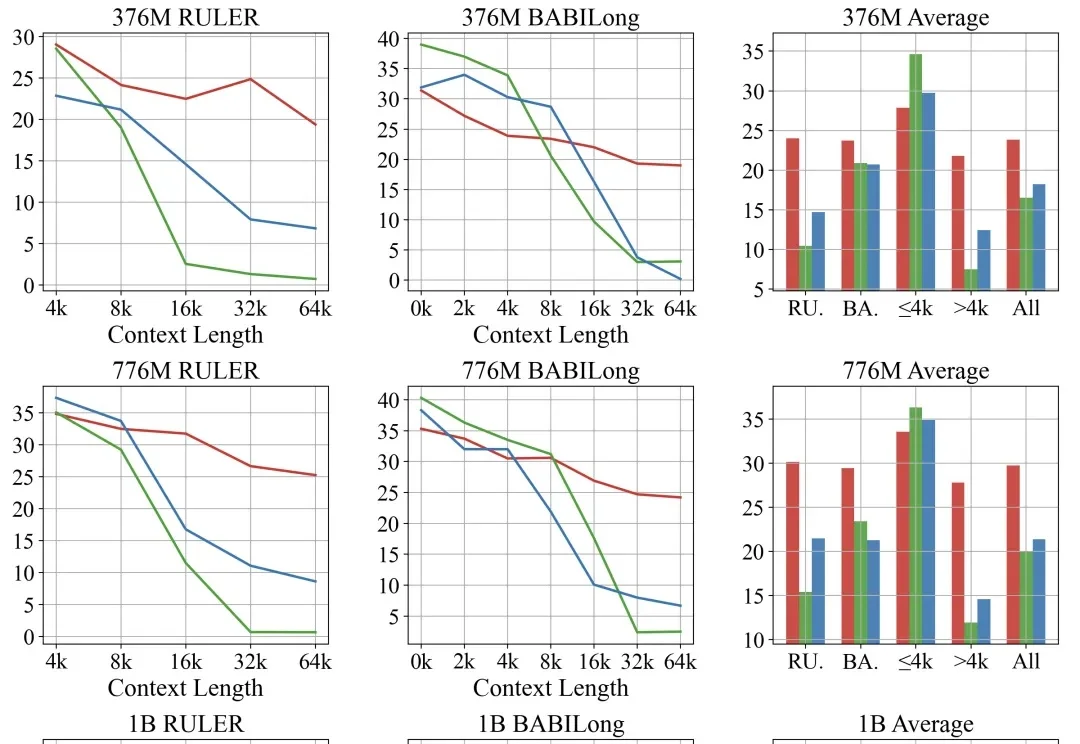
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。