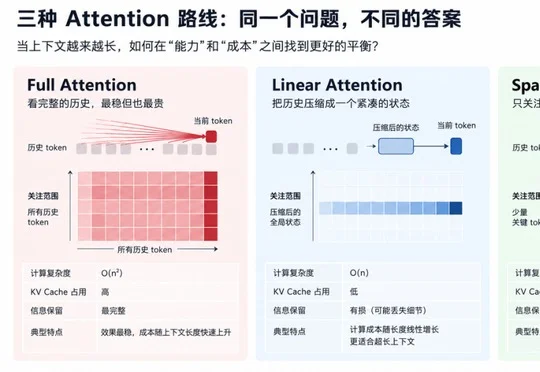
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
7497 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
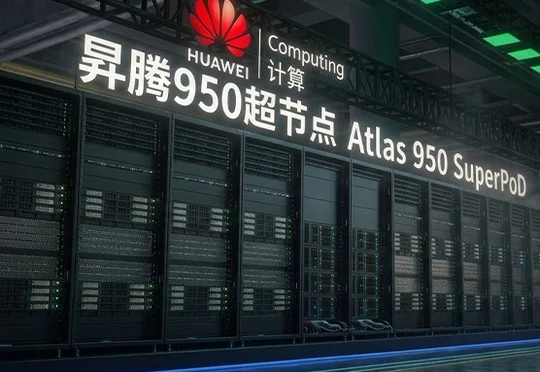
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
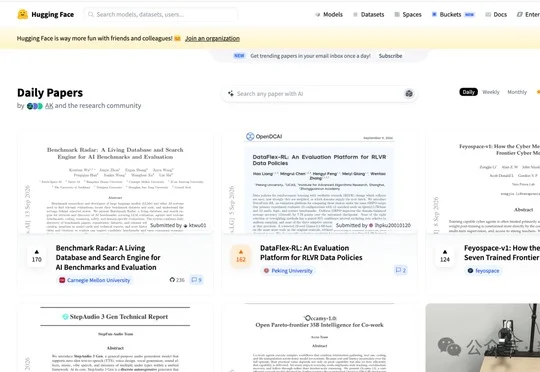
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
大模型训练拼的是算力,Agent训练拼的是环境。
大模型江湖变天了。
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
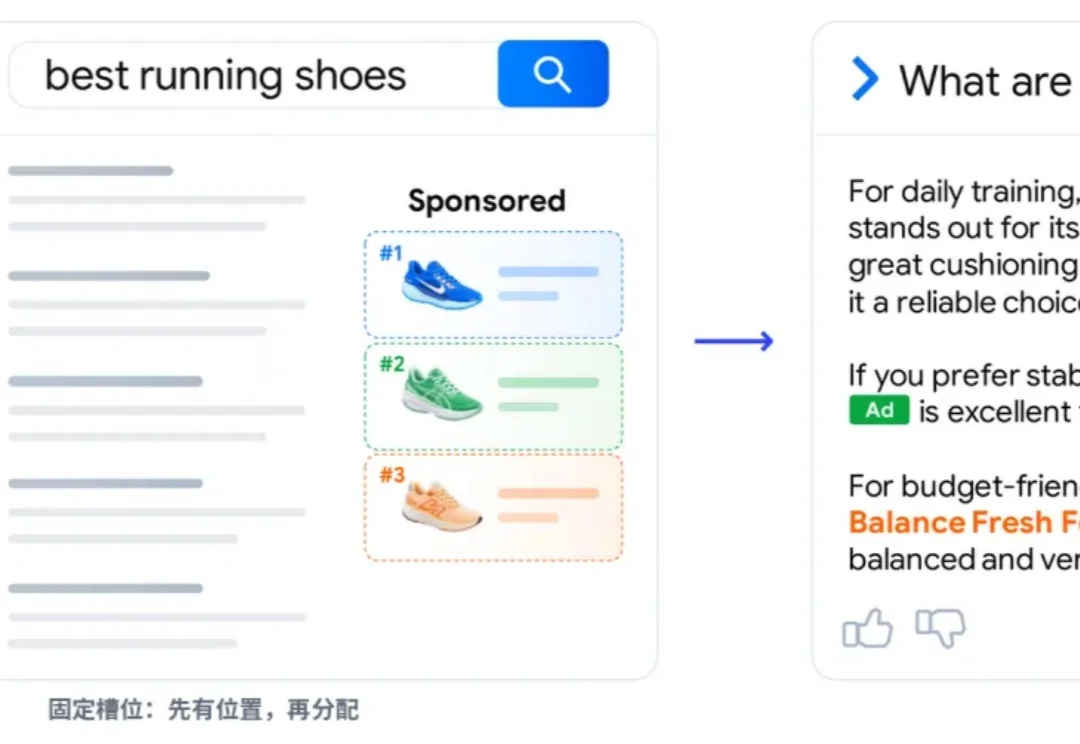
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。