独家|初创公司橡木果机器人走出隐身模式:9名清华博士创办,0数据让机器人靠“本能”干活
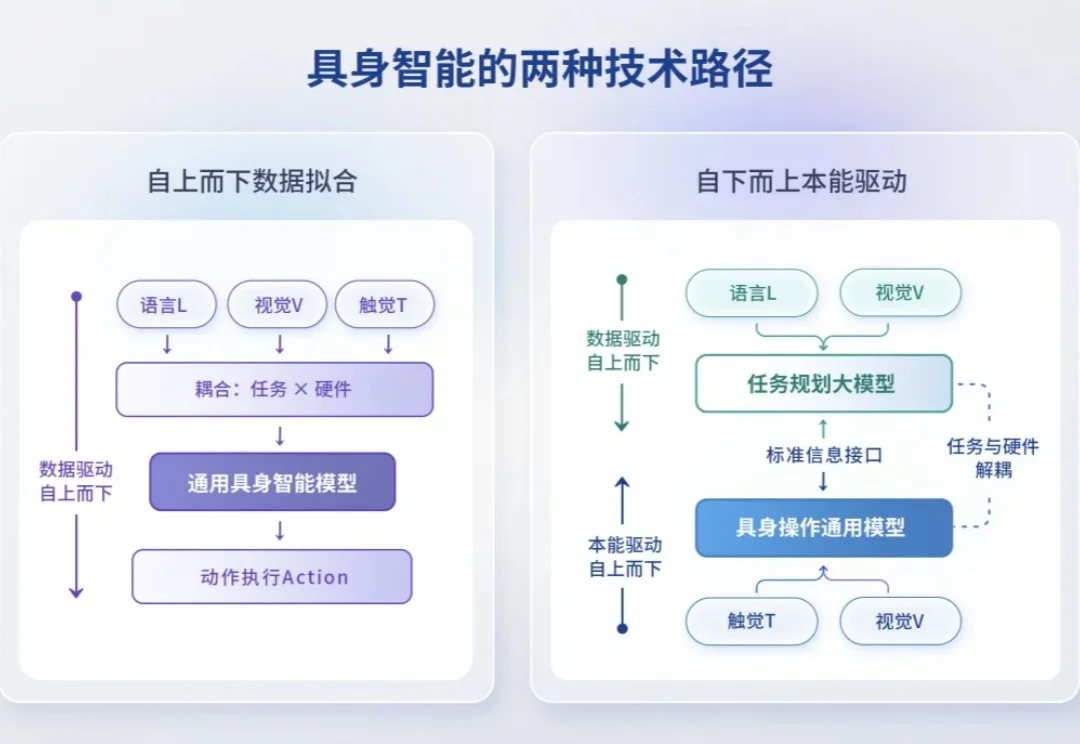
独家|初创公司橡木果机器人走出隐身模式:9名清华博士创办,0数据让机器人靠“本能”干活2018 年从哈佛回国时,橡木果机器人的发起人姜峣有了一个判断:语言和操作,是两种完全不同的智能。
来自主题: AI资讯
11799 点击 2026-06-02 12:20

 搜索
2018 年从哈佛回国时,橡木果机器人的发起人姜峣有了一个判断:语言和操作,是两种完全不同的智能。
这是第一次,机器人学会了用手「盘」:
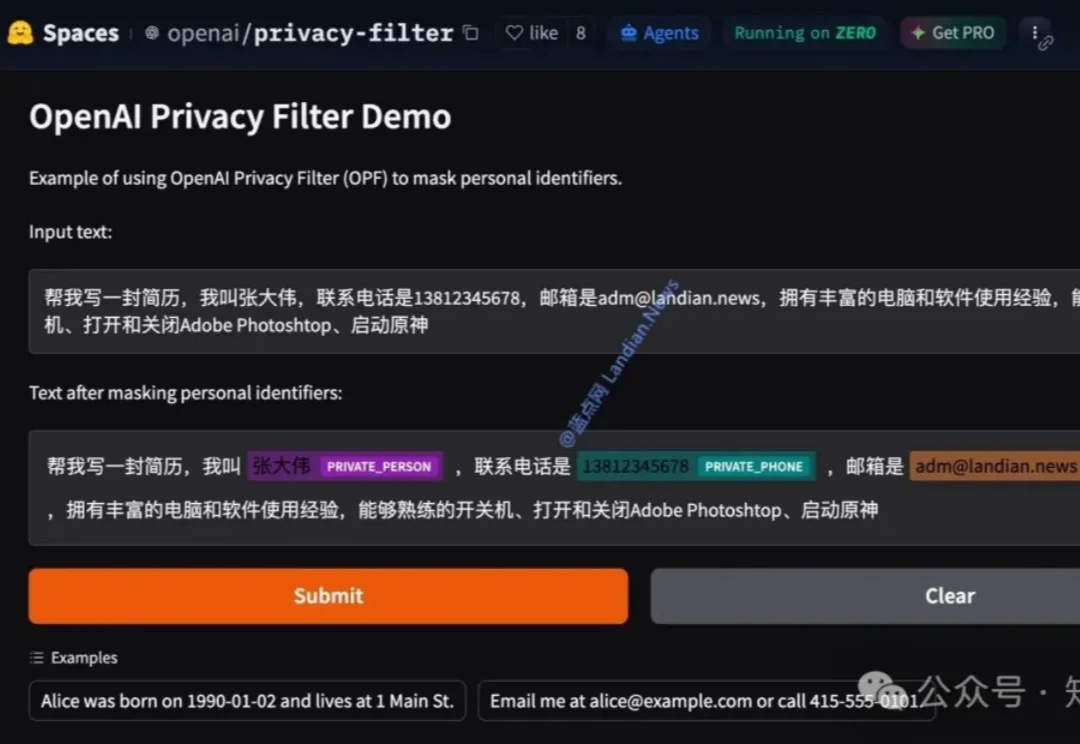
你有没有过这样的经历:把聊天记录、用户反馈或内部文档丢给大模型时,总担心里面夹杂着真实姓名、手机号、邮箱甚至 API key,最后只能手动一条条删?或者团队在处理海量数据时,规则写的正则永远漏掉那些“藏在句子里的隐私”。
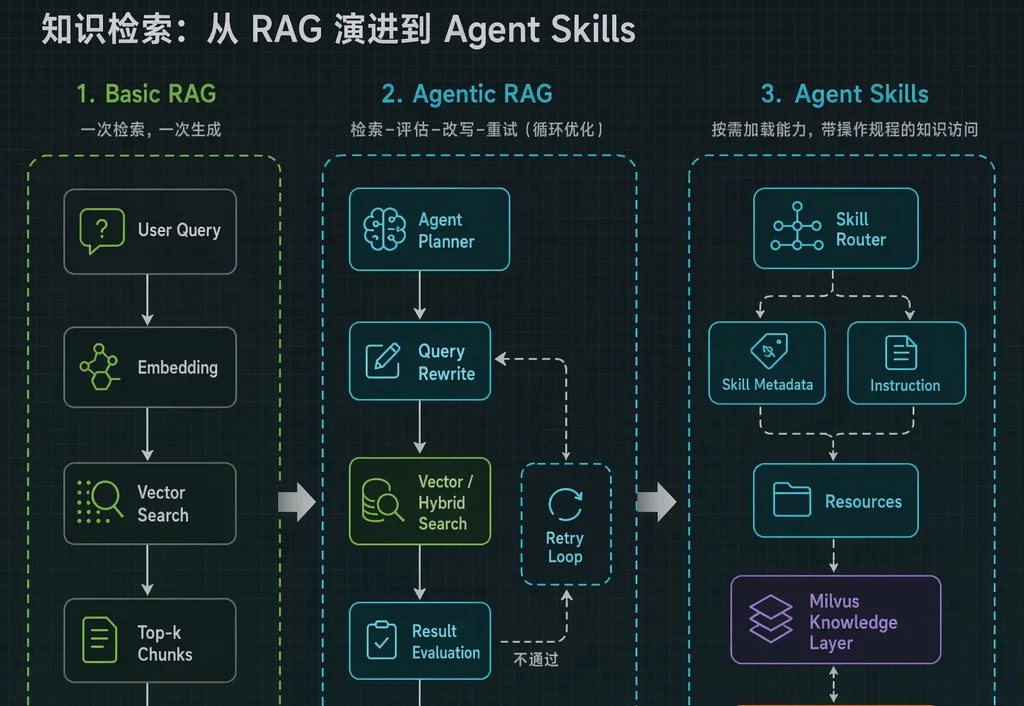
最近一两年,互联网上各种为RAG赛博哭坟的帖子不胜枚举。
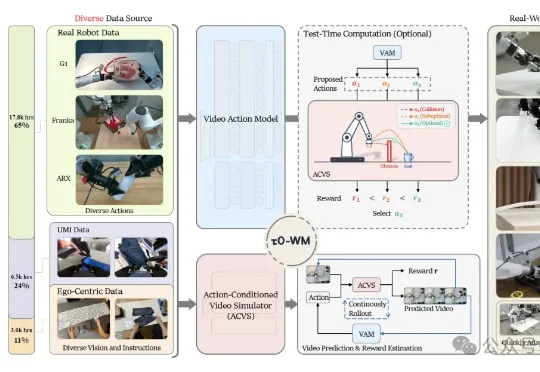
刚刚,上海创智学院副教授、智元机器人首席科学家罗剑岚带队,发布全球最大规模的开源预训练具身世界模型——τ0-World Model(τ0-WM)。整个τ0-WM参数量达到5B,预训练数据规模高达约3万小时。其中,真机遥操作数据第一次成了绝对主力,占到了1.78万小时。
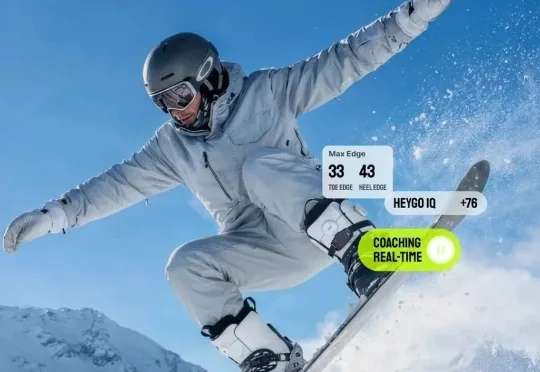
Heygo.ai对比每一次滑行数据,分析动作变化,并明确告诉接下来需要改进的地方。基于你的专属数据、滑行风格、习惯,为有经验的爱好者制定一套系统化的训练方案,精准攻克薄弱环节。
大模型从“回答问题”走向“完成任务”,正在面临以下瓶颈:面向Claw Agents的数据、训练和评测都比传统environment training更难。为了解决该问题,中国人民大学、至知研究院等最新提出ClawGym——
2026年5月,两篇重磅研究在一周内相继发表。一组来自加州大学伯克利分校研究团队,样本是美国 20 所公立研究型大学的 95,513 名本科生。研究发表在《Science》科学杂志上,主题是大学生如何使用生成式 AI,以及怎样用它作弊。
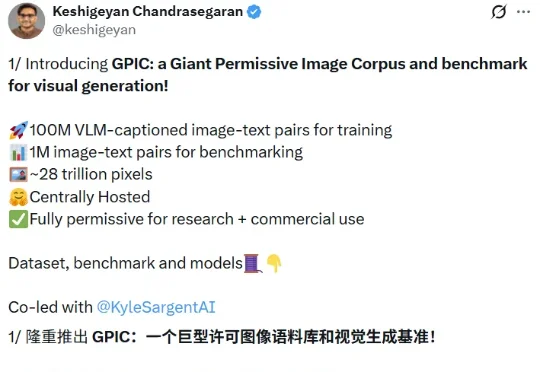
就在前两天,斯坦福大学等机构发布了一个名为 GPIC(Giant Permissive Image Corpus,巨型开放图像语料库)的数据集。
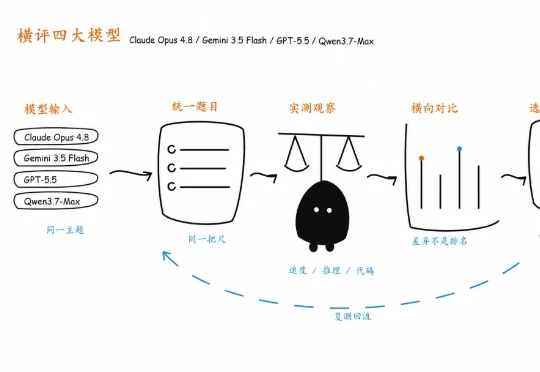
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。