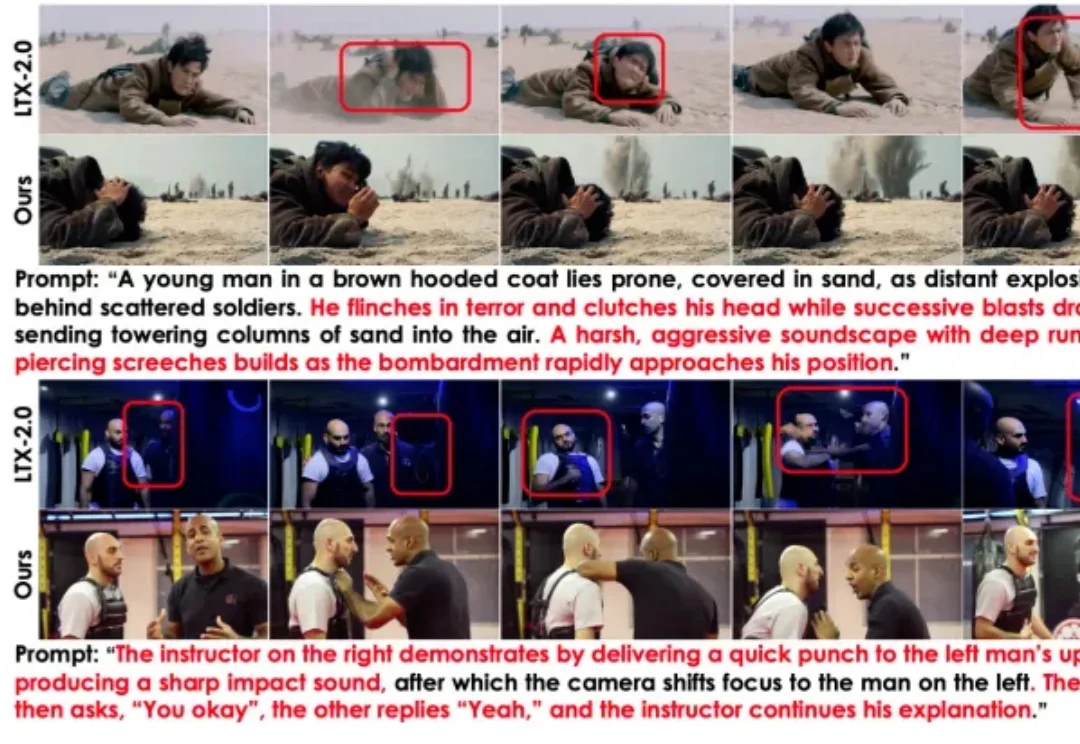
指令遵循媲美Seedance 2.0!复旦腾讯联合提出Baton,多说话人场景M-WER暴降76%
指令遵循媲美Seedance 2.0!复旦腾讯联合提出Baton,多说话人场景M-WER暴降76%视频生成,早已不止于视觉。
来自主题: AI技术研报
15194 点击 2026-06-11 15:01

 搜索
视频生成,早已不止于视觉。
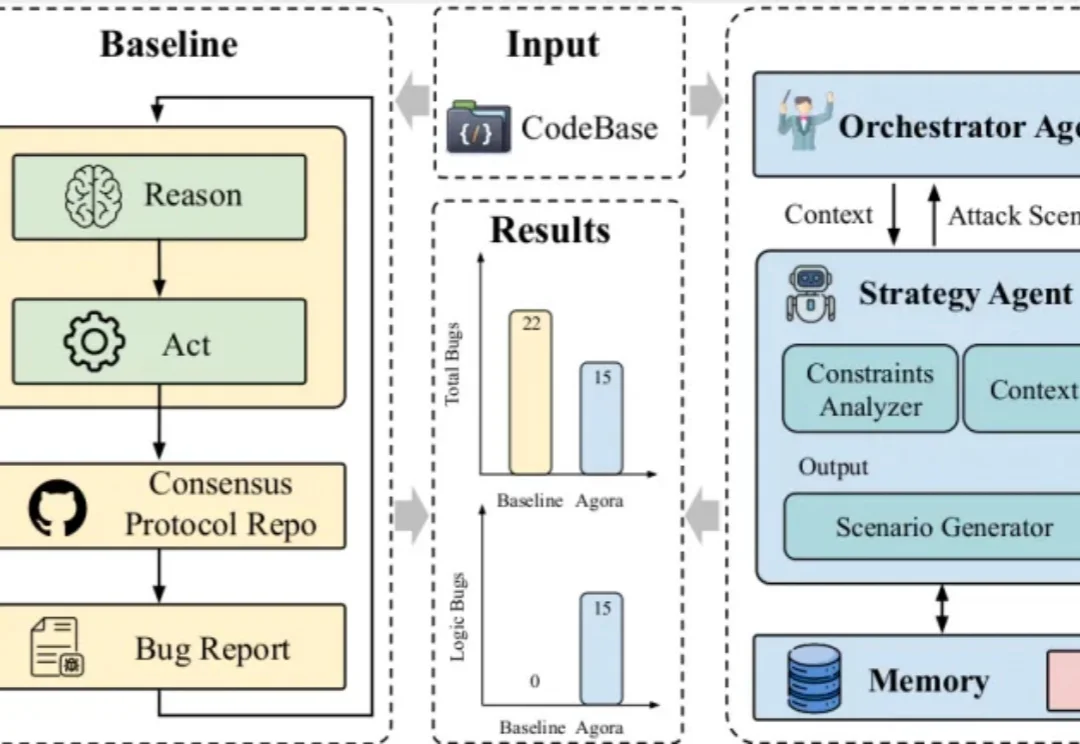
分布式系统的 “圣杯”—— 共识协议(Consensus Protocols),长久以来都是顶级基础设施工程师的 “Bug 地狱”。由于其状态极其复杂、多节点交织,传统测试和单体 LLM 对硬核的 Deep Bug(深层逻辑漏洞)几乎束手无策。
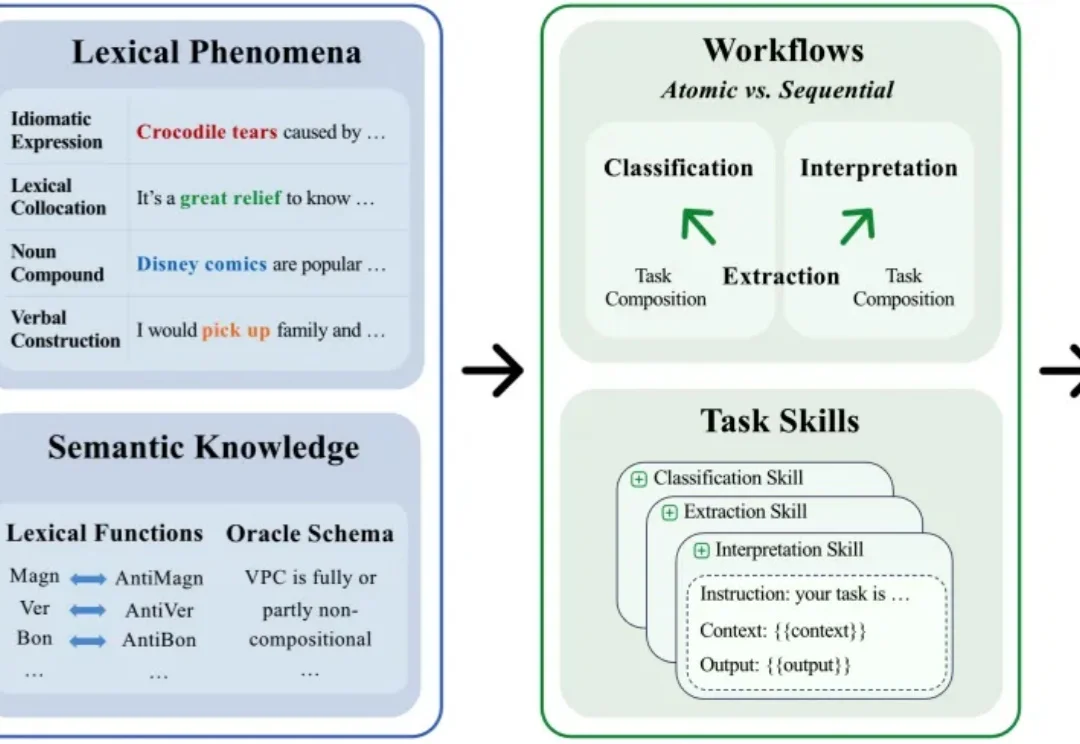
AI 的能力边界正在不断被刷新。从数学推理到代码生成,再到数字化白领,语言模型和语言智能体在诸多基准测试中已展现出超越人类专家的表现。一个看似顺理成章的判断早已成为共识:语言模型已经具备了扎实的语言理解和语义推理能力。然而,ACL 2026 Oral 的一项研究工作从一个更基础的层面重新审视了这个问题:语言模型真的理解(短语)语义吗?
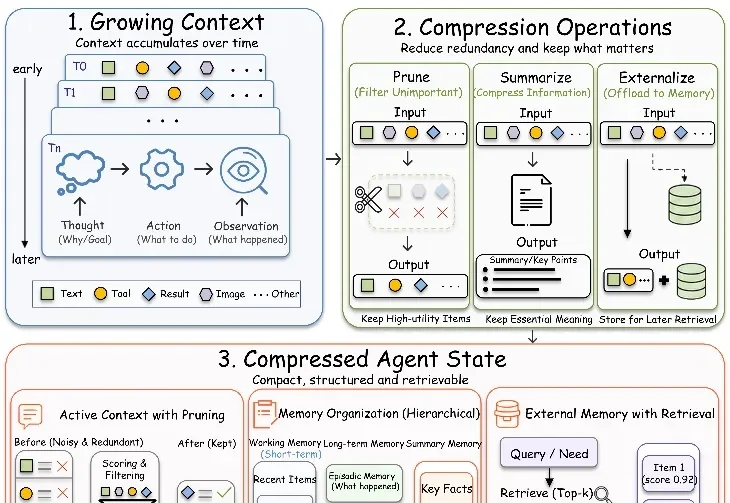
LLM Agent 做长任务时,真正让人头疼的往往不是模型不会推理,而是上下文开始失控:前几步还很清楚,后面就忘约束、丢状态、重复试错,最后把任务跑成事故现场。
Fable 5正在引发众多质疑:一声「你好」就能触发警报,一问高端技术就会被暗箱降智。Anthropic的安全承诺,正在变成一场开源圈愤怒的「安全谎言」。
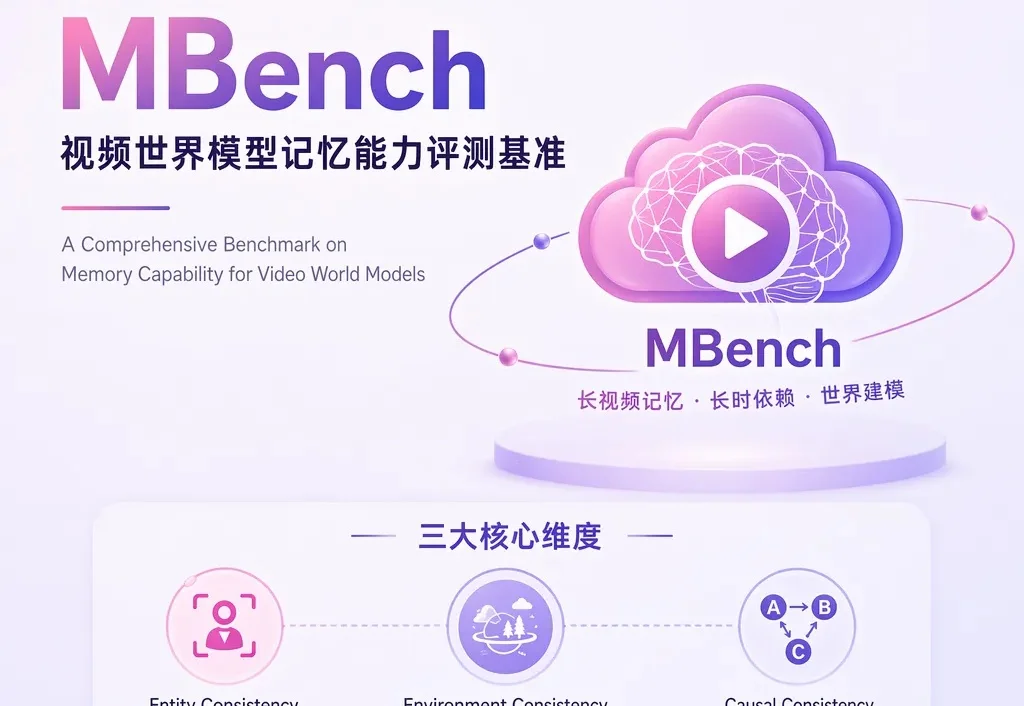
随着视频生成技术的发展,模型正在从短视频片段合成,向流式长视频生成演进。然而,仅仅做到视觉上的逼真是不够的。一个功能完备的视频世界模型,必须能够在长时序交互中保持稳定的内部状态,并遵循真实世界的物理定律与逻辑规则。
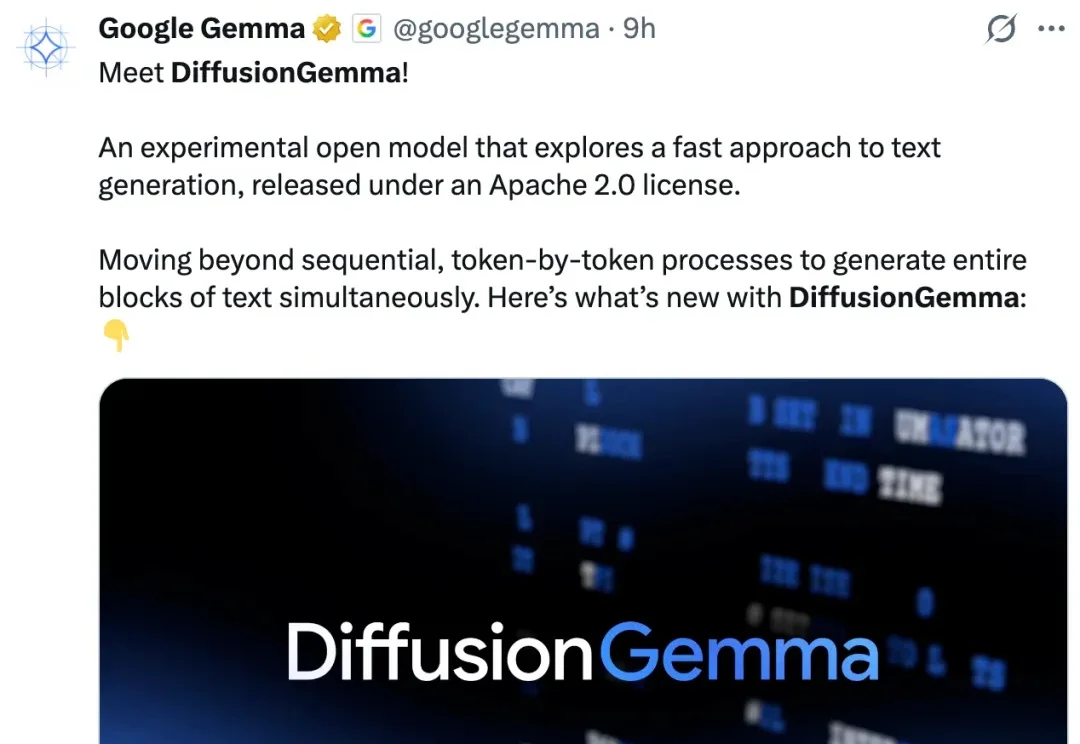
今天一早,谷歌又发新模型了!
独家获悉,GUI Agent(图形用户界面智能体)执行平台 「Core-Mate」 近日宣布完成数千万人民币融资。核心团队主要来自字节跳动,成员在用户产品、业务增长和商业化落地中积累了系统经验。在团队看来,下一代 AI 产品的关键不只在模型能力,也在入口、场景和用户行为。
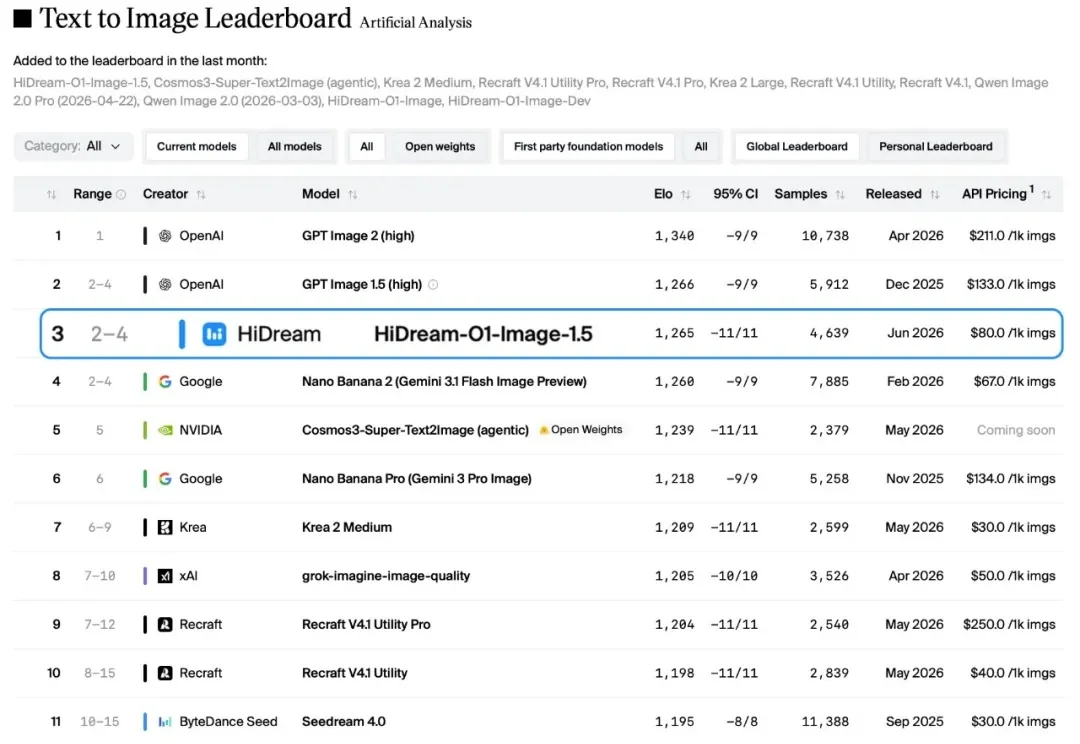
文生图的"慢思考",到底有没有用?
过去一年,开源模型的发布节奏已经快到让人麻木。每次发布,伴随的永远是一组跑分、一张能力雷达图,以及几个“超越某某”的结论。