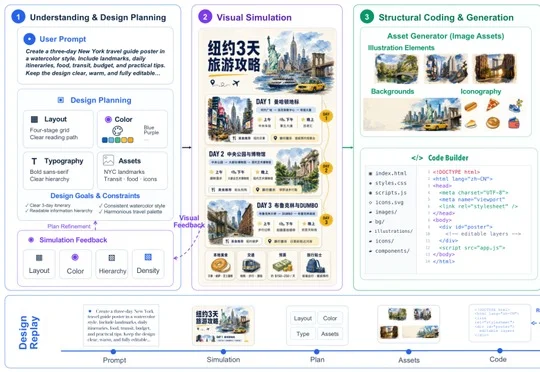
开源Editable-Design,让AI生图终于能改字、拖图层
开源Editable-Design,让AI生图终于能改字、拖图层开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
来自主题: AI技术研报
7897 点击 2026-09-19 14:55

 搜索
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
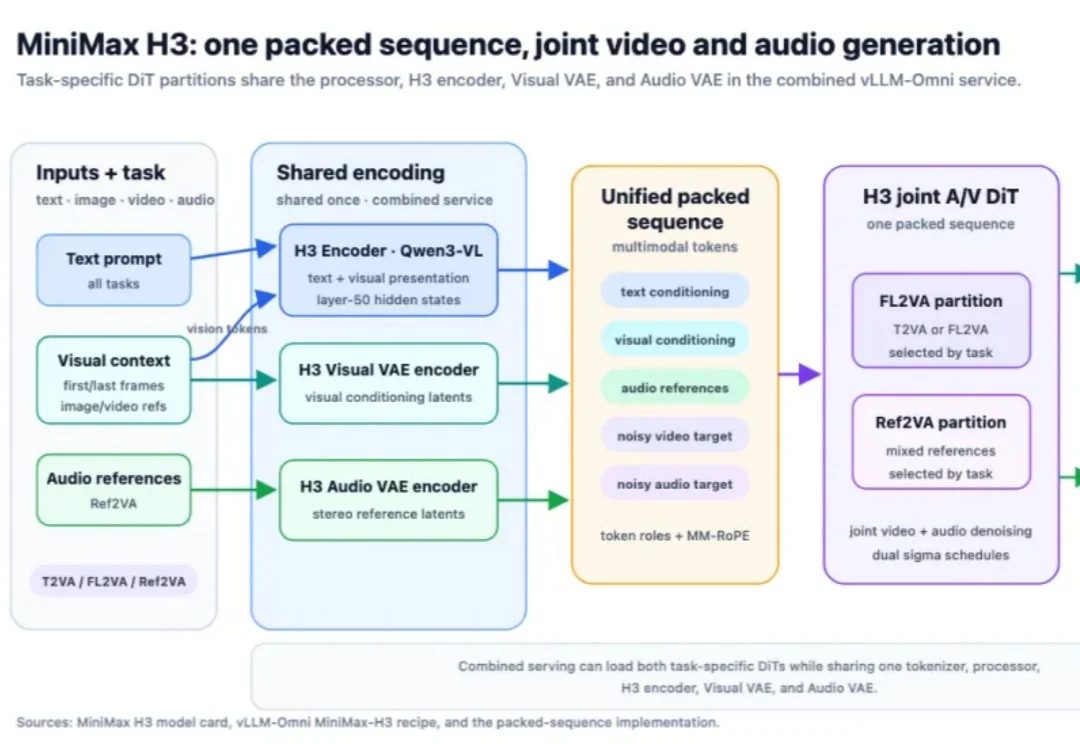
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
有多少人知道或者玩过人人网/校内网?绝对不是要蹭孙割流量……
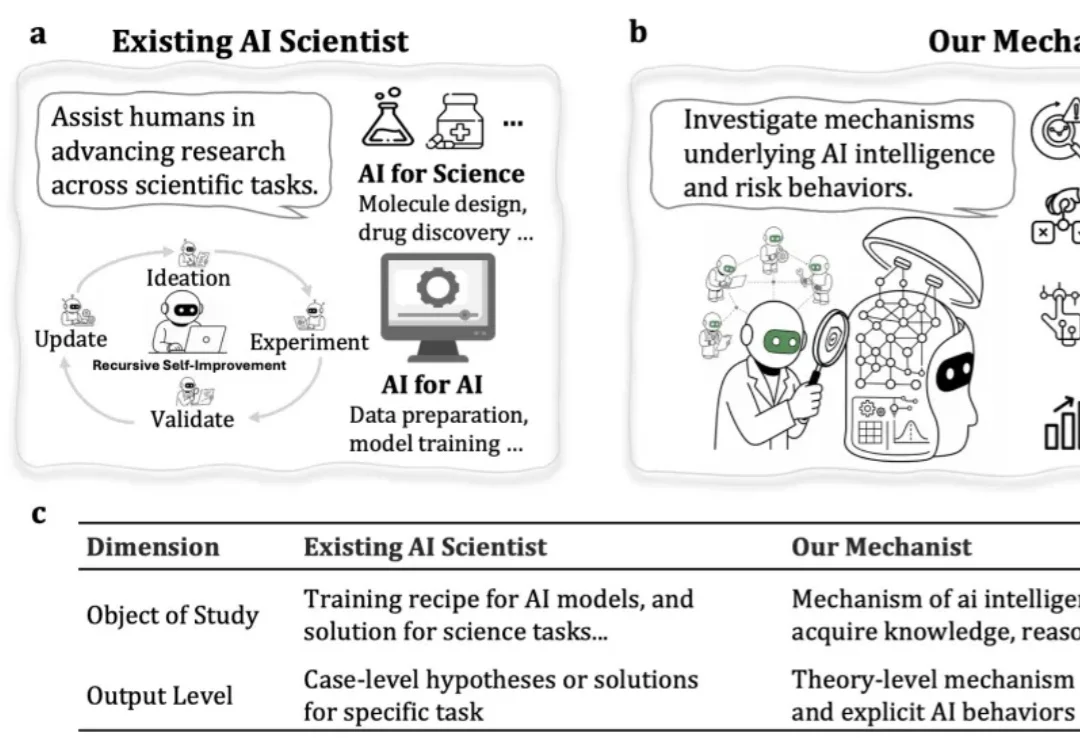
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
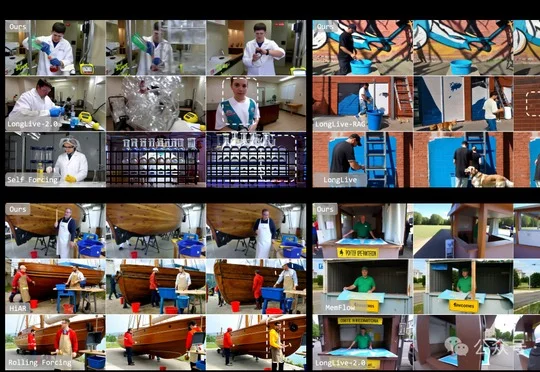
浙大与港大团队开源轻量化记忆路由器LayerRecall,通过选择性检索历史记忆并仅注入对长程信息敏感的特定DiT层,解决长视频生成中角色离场再返回时身份与属性丢失的问题,在MemoBench和MovieBench评测中取得Overall第一,且约6.6MB的路由权重可零再训练迁移至其他视频生成骨干。
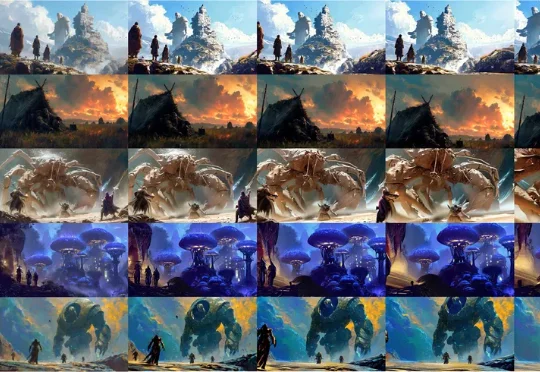
香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
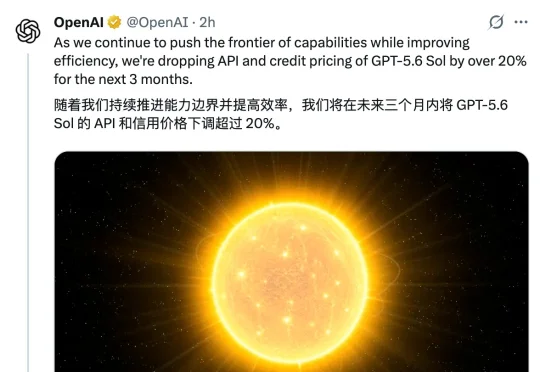
突发,GPT-5.6 Sol 开启大幅降价!未来三个月,API 价格和 credit 价格(超出计划包含额度后的按需付费用量)一起砍掉超过20%。目前,API 端已经即时生效,符合条件的 ChatGPT Work 和 Codex credits 正在陆续推送。

今天的视频生成模型,已经越来越像一个会拍电影的导演。

图像生成模型正从「会创作」转向「可操作」。

只做一次生成器前向,就能得到一张图,这是一步生成追求的效率。但想把采样步数降到 1,难题其实在训练端:怎样用足够稳定、简单的监督信号,让生成分布靠近真实分布?